
图的基本算法——BFS、DFS、拓扑排序、强连通分支、最小生成树算法
图
图的基本算法
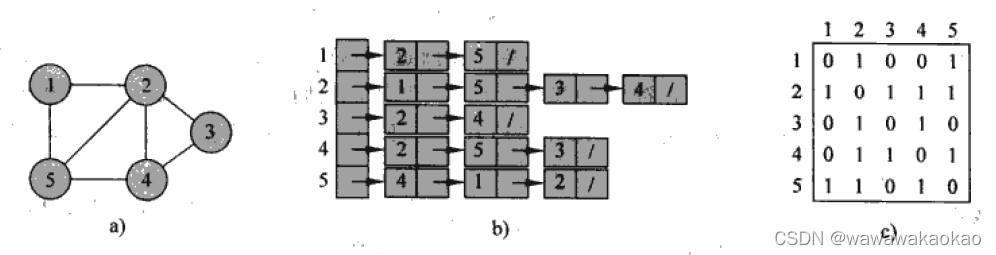
图的表示
邻接矩阵
邻接表
BFS搜索
在给定图G=(V,E)G=(V,E)G=(V,E)和一个特定的源顶点s的情况下,广度优先搜索系统的探索G中的边,以期“发现”可从s到达的所有顶点,并计算s到所有这些可达顶点之间的距离(即最少的边数)。该搜索算法同时还能生成一颗根为s、且包括所有s的可达顶点的广度优先树。
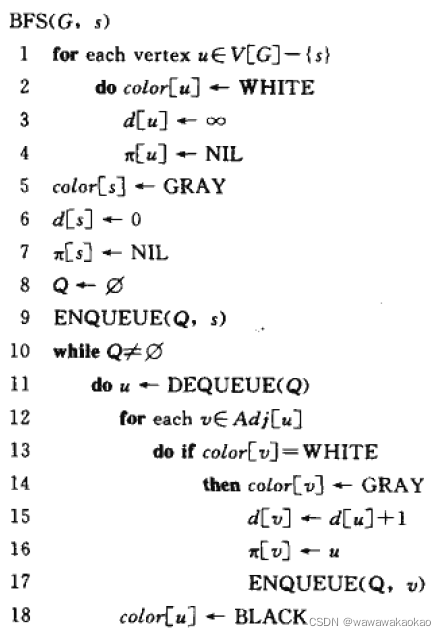
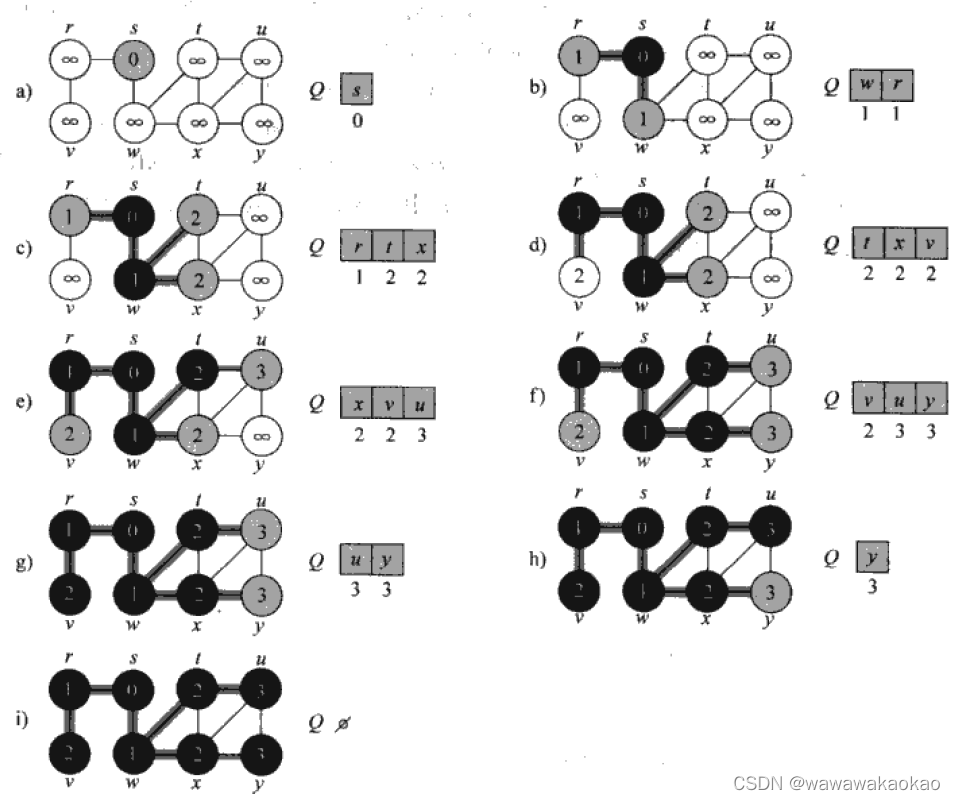
广度优先搜索产生的广度优先树可能会有所不同,但由算法计算出来的距离d都是一样的。
时间复杂度 O(V+E)O(V+E)O(V+E)
对于图,广度优先搜索可以得到从已知源顶点到每个可达顶点的距离(最短路径)。
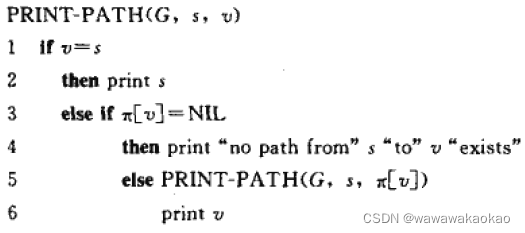
打印广度优先搜索路径
DFS搜索
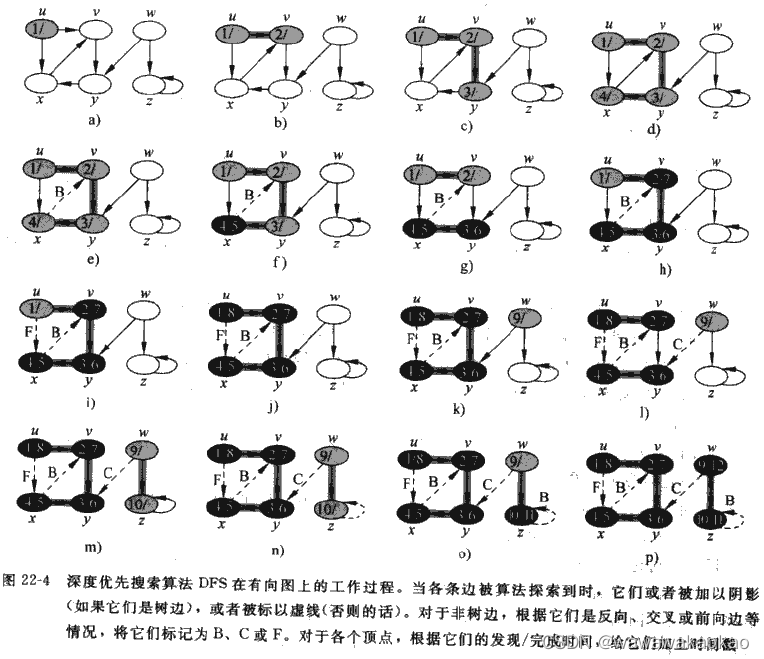
DFS时间复杂度O(V+E)O(V+E)O(V+E)。
深度优先搜索性质:可以获得有关图结构的有价值的信息,另一个重要特性是发现和完成时间具有括号结构。
拓扑排序
运用深度优先搜索对有向无环图进行拓扑排序。
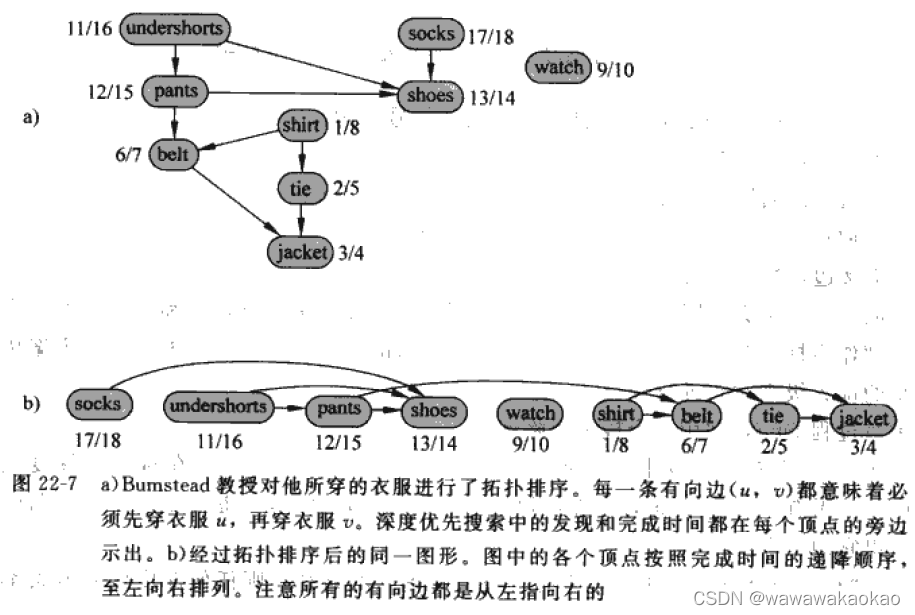
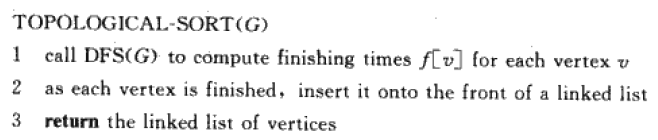
执行拓扑排序的时间复杂度是O(V+E)O(V+E)O(V+E)。
强连通分支
深度优先搜索的经典应用:把一个有向图分解为各强连通分支。分解之后,算法即可在各一个强连通分支上独立地运行,最后再根据各个分支之间的关系将所有的解组合起来。
定义:有向图G=(V,E)G=(V,E)G=(V,E)的一个强连通分支就是一个最大的顶点集合C∈VC\in VC∈V,对于C中每一对顶点,其二者互相可达。
在计算强连通分支时,用到了G的转置,即G中边的方向改变。GGG与GTG^TGT有着完全相同的强连通分支。通过调用两次DFS,一次应用在G上,一次应用在G的转置上,可以实现该算法。
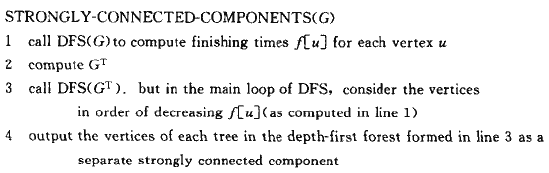
本算法的重要思想是分支图是一个有向无回路图。算法的时间复杂度为O(V+E)O(V+E)O(V+E)。
最小生成树
一个无向连通图G=(V,E)G=(V,E)G=(V,E) ,对图中每一条边(u,v)∈E(u,v)\in E(u,v)∈E 都有一个权值w(u,v)w(u,v)w(u,v) 表示连接u和v的代价,我们希望找到一个无回路的子集T∈ET\in ET∈E ,他连接了所有的顶点,且其权值之和 w(T)=∑(u,v)∈Tw(u,v)w(T)=\sum_{(u,v)\in T} w(u,v)w(T)=∑(u,v)∈Tw(u,v) 为最小。因为其无回路,必然是一棵树,称为生成树T,把确定生成树T的问题称为最小生成树。
最小生成树通用贪心算法
循环不变式:在每一次循环迭代之前,A是某棵最小生成树的一个子集
在算法的每一步中确定一条边(u,v)(u,v)(u,v) 使得它加入集合A后仍然不违反这一循环不变式。
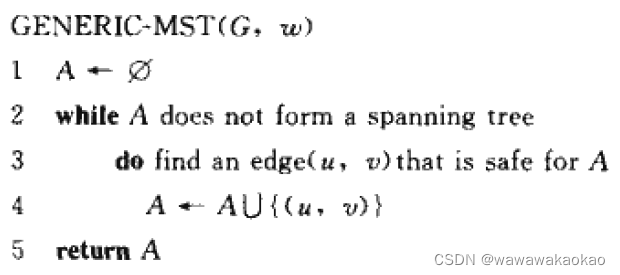
1、满足生成树的定义,2、满足最小的定义
识别安全边的定理:
设图G=(V,E)G=(V,E)G=(V,E)是一个无向连通图,并且在E上定义了一个具有实数值得加权函数w,设A是E得一个子集,它包含于G得某个最小生成树中,设割(S,V−S)(S,V-S)(S,V−S)是G得任意一个不妨害A的割,且边(u,v)(u,v)(u,v)是通过割(S,V−S)(S,V-S)(S,V−S)的一条轻边(权值最小边),则边对集合A是安全的。
推论:设C=(VC,EC)C=(V_C,E_C)C=(VC,EC)为森林GA=(V,A)G_A=(V,A)GA=(V,A)的一个连通分支(树),如果边(u,v)(u,v)(u,v)是连接CCC和GAG_AGA中其他某连通分支的一条轻边,则对集合AAA来说是安全的。
每次找边(u,v)(u,v)(u,v)即可
Kruskal算法
Kruskal算法找出森林中连接任意两棵树的所有边中,具有最小权值(贪心)的边作为安全边(安全边性质由上述推论保证),并把它添加到正在生长的森林中。
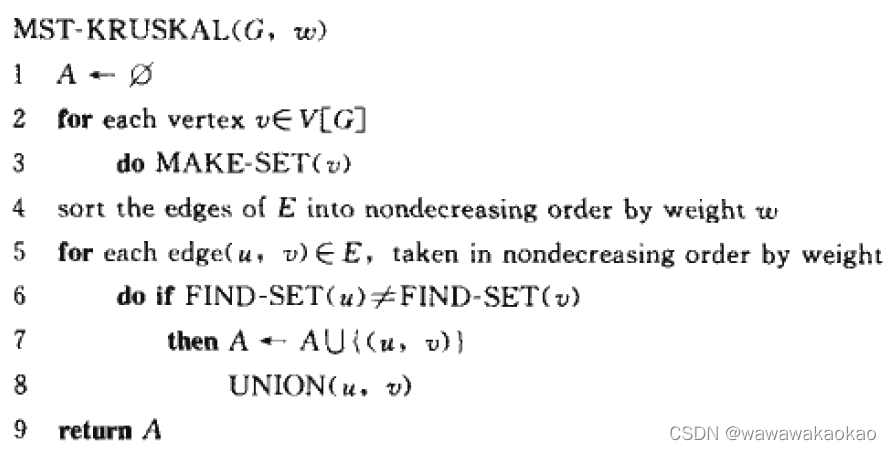
第1-3行将集合A初始化为空集,并建立∣V∣|V|∣V∣棵树,每棵树都包含图的一个顶点,在第4行根据权值对E中边进行非递减顺序排序,第5-8行循环中,首先检查每条边其端点是否属于同一棵树,是则放弃,否则把边加入集合A,并对两棵树中的顶点进行合并。
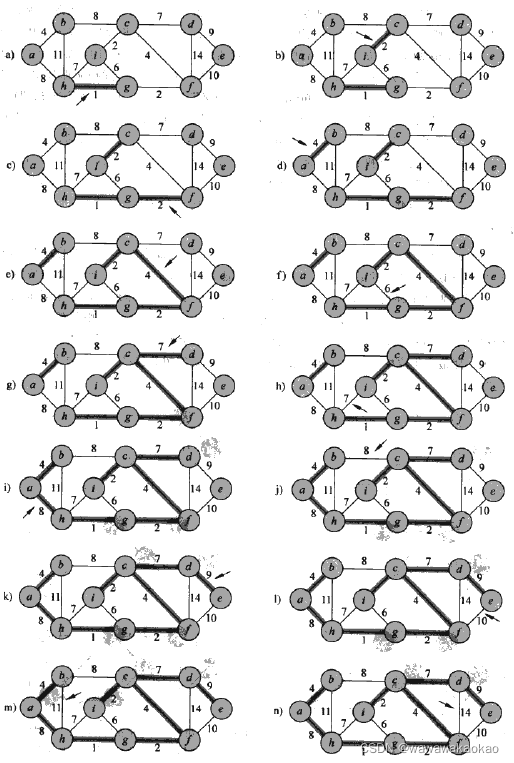
Kruskal算法时间复杂度为:O(ElgV)O(E\lg V)O(ElgV)
Prim算法
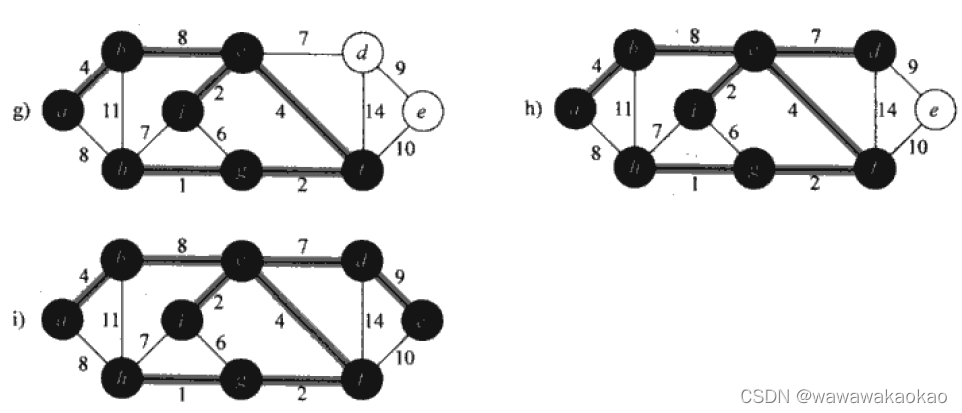
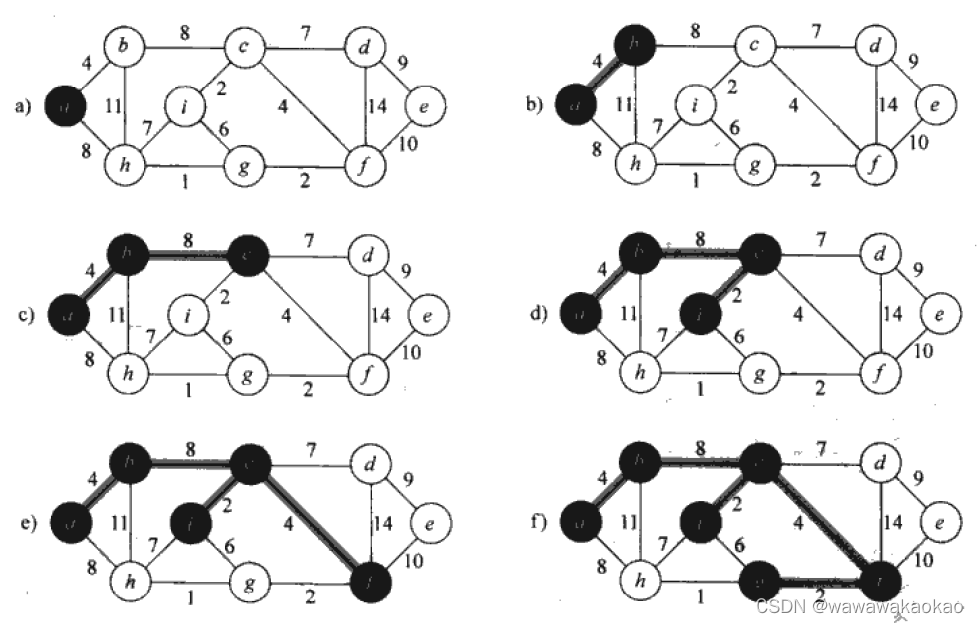
Prim算法的特点是集合A中的边总是形成单棵树,树从任意根顶点r开始形成,并逐渐生成,直至该树覆盖了V中的所有顶点。Prim算法的关键是设法较容易地选择一条新的边,将其添加进由A地边所形成的树中。
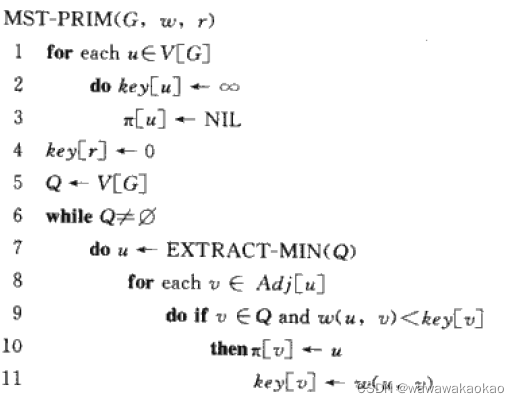
第1-5行置每个顶点地key域为∞\infin∞(key[v]key[v]key[v]是所有将v与树中某一顶点相连的边中的最小权值),根r的key域被置为0,这样它就会成为第一个被处理的顶点,将每个顶点的父顶点置为NIL(π[v]\pi [v]π[v]),并初始化最小优先级队列Q,使之包含所有的顶点。
在6-11行中while循环的每一次迭代之前有
A={(v,π[v]):v∈V−r−Q}A=\{(v,\pi[v]):v\in V-{r}-Q\}A={(v,π[v]):v∈V−r−Q};
已经被放入的最小生成树中的节点都是V-Q中的顶点;
对所有的节点V∈QV\in QV∈Q来说,如果π[v]≠NIL\pi[v]\neq NILπ[v]=NIL,则key[v]≠∞key[v]\neq \infinkey[v]=∞,且key[v]key[v]key[v]是一条轻边(v,π[v])(v,\pi[v])(v,π[v])的权值,该边连接了v与已经在最小生成树中的某个顶点。
Prim算法的性能取决于优先队列Q是如何实现的。如果使用二叉最小堆来实现,则时间复杂度为O(ElgV)O(E\lg V)O(ElgV)。使用斐波那契堆,则算法时间复杂度可改进到O(E+VlgV)O(E+V\lg V)O(E+VlgV)。
]
Prim算法的性能取决于优先队列Q是如何实现的。如果使用二叉最小堆来实现,则时间复杂度为O(ElgV)O(E\lg V)O(ElgV)。使用斐波那契堆,则算法时间复杂度可改进到O(E+VlgV)O(E+V\lg V)O(E+VlgV)。
更多推荐


 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)