
数据结构(十)——KMP算法
一、KMP算法简介
1、通用暴力匹配算法
通常的字符串匹配算法流程如下:
从主串(目标字符串)和模式串(待匹配字符串)的第一个字符开始比较,如果相等则继续匹配下一个字符, 如果不相等则从主串的下一个字符开始匹配,直到模式串被匹配完,则匹配成功,或主串被匹配完且模式串未匹配完,则匹配失败。如图:
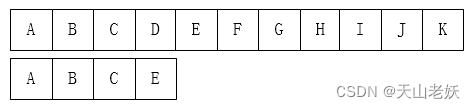
目标字符串为“ABCDEFGHIJK”,模式字符串为“ABCE”,从左到右逐个字符匹配,如果匹配过程中有某个字符不匹配,就跳回去,将模式串整体向右移动一位,继续进行匹配。
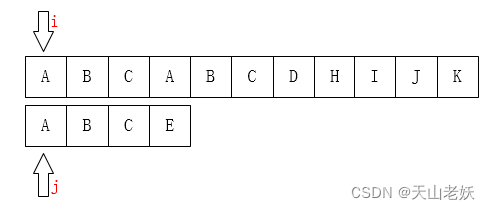
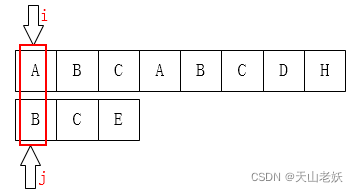
只需要比较i指针指向的字符和j指针指向的字符是否一致。如果一致就都向后移动,如果不一致,如下图:
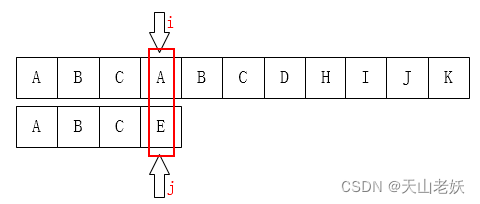
A和E不相等,把i指针移回第1位(假设下标从0开始),j移动到模式串的第0位,然后重新开始匹配步骤,如下图:
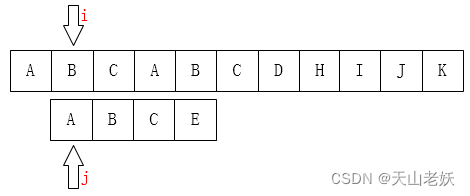
通用暴力匹配的思路,假设现在文本串S匹配到i位置,模式串P匹配到j位置,则有:
如果当前字符匹配成功(即S[i] == P[j]),则i++,j++,继续匹配下一个字符;
如果匹配失败(即S[i]! = P[j]),令i = i - (j - 1),j = 0,即每次匹配失败时,i回溯,j被置为0。
暴力匹配算法实现如下:
/****************************************
 *函数名称:通用暴力匹配算法
 *参数s:目标字符串
 *参数p:要查找匹配的模式字符串
 ***************************************/
int generalMatch(const char* s, const char* p)
{
    int index = -1;
    int sLen = strlen(s);
    int pLen = strlen(p);
    //移位比较,在目标字符串上移位,范围从0至sLen - pLen
    for(int i = 0; (index < 0) && (i <= (sLen - pLen)); i++)
    {
        bool equal = true;
        //将模式字符串逐位字符与目标字符串字符进行比较
        for(int j = 0; equal && (j < pLen); j++)
        {
            equal = equal && (s[i+j] == p[j]);
        }
    }
    return index;
}

int generalMatch(const char* s, const char* p)
{
    int index = -1;
    int sLen = strlen(s);
    int pLen = strlen(p);
    int i = 0;
    int j = 0;
    while((index < 0) && (i < sLen) && (j < pLen))
    {
        //如果目标字符串与模式字符串逐位比较时字符相等,连续比较
        if(s[i] == p[j])
        {
            i++;
            j++;
        }
        else
        {
            i = i - j +1;//i回溯
            j = 0;//j回溯
        }

        //如果找到匹配的模式字符串,跳出循环
        if(j == pPLen)
        {
            index = i - j;
        }
    }

    return index;
}
暴力匹配算法效率太低,根据模式字符串查找的一般方法,不停对模式字符串移位比较,右移位数可以变化,不必每次右移一位。如下图:
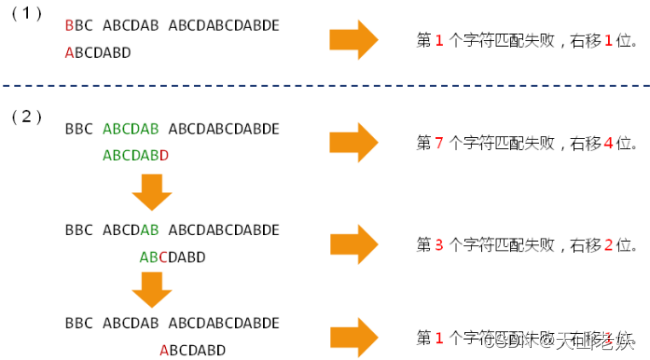
模式字符串查找中,匹配失败时右移位数与模式字符串本身有关,与目标字符串无关,因此可以利用已经部分匹配的字符的有效信息,保持目标字符串的指针i不回溯,通过修改模式字符串的指针j的位置,让模式串尽量地移动到有效的位置,提高匹配的效率,即KMP算法的思想。
2、KMP算法简介
Knuth-Morris-Pratt字符串查找算法,简称为“KMP算法”,常用于在一个文本串S内查找一个模式串P的出现位置,KMP算法由Donald Knuth、Vaughan Pratt、James H. Morris三人于1977年联合发表。KMP算法的关键是利用匹配失败后的信息(已经匹配的部分中的对称信息),尽量减少模式串(待搜索词)与文本串的匹配次数以达到快速匹配的目的。
KMP算法的流程如下:
假设现在文本串S匹配到i位置,模式串P匹配到j位置,
如果j = -1,或者当前字符匹配成功(即S[i] == P[j]),令i++,j++,继续匹配下一个字符;
如果j != -1,且当前字符匹配失败(即S[i] != P[j]),则令i不变,j = next[j],即模式串P相对于文本串S向右移动了j - next [j]位。当匹配失败时,模式串向右移动的位数为:失配字符所在位置 - 失配字符对应的next值即移动的实际位数为:j - next[j],且此值大于等于1。
next数组各值的含义:代表当前字符之前的字符串中,有多大长度的相同前缀后缀。例如next [j] = k,代表j之前的字符串中有最大长度为k 的相同前缀后缀,即在某个字符失配时,该字符对应的next值会告诉下一步匹配中,模式串应该跳到哪个位置(跳到next[j]的位置)。如果next[j]等于0或-1,则跳到模式串的开头字符,若next[j] = k 且 k > 0,代表下次匹配跳到j之前的某个字符,而不是跳到开头,且具体回溯跳过了k个字符。
3、KMP算法的匹配过程
KMP算法的匹配过程如下:
当某一个字符与目标字符串不匹配时,模式字符串的j指针要移动到哪一个位置?
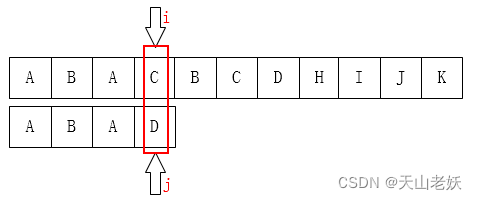
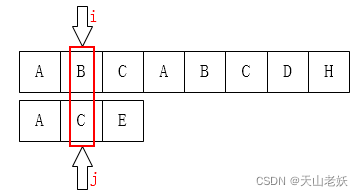
上图,C和D不匹配,不回溯i指针,要把j移动到哪一个位置?显然是第1位。因为前面有一个A已经匹配。如下图:
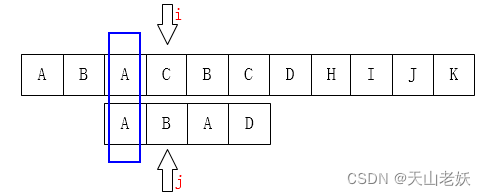
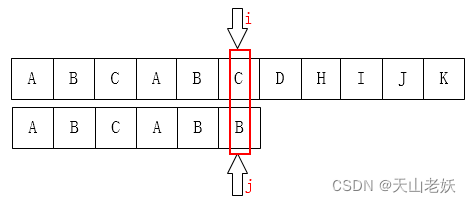
上图中C与B不匹配,i不回溯,j需要移动到第2的位置,因为AB字符已经匹配,如下图:
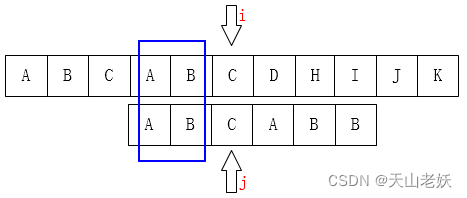
KMP算法的改进之处在于:能够知道在匹配失败后,有多少字符是不需要进行匹配可以直接跳过的,匹配失败后,下一次匹配从什么地方开始,能够有效的减少不必要的匹配过程。
因此,当匹配失败时,模式字符串的游标指针j要向左回溯移动到的下一个位置k存在着这样的性质:k位置的最前面的k个字符和j位置前的最后k个字符是一样的。
数学公式:P[0 ~ k-1] == P[j-k ~ j-1]
如下图:
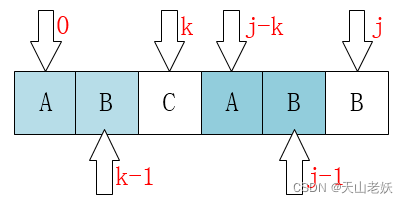
上图即k位置的前2个字符AB与j位置前的最后两个字符AB相同。
证明如下:
当T[i] != P[j]时
有T[i-j ~ i-1] == P[0 ~ j-1] //模式字符串中的前j-1个字符与目标字符串中的i-j~i-1子字符串匹配。
由P[0 ~ k-1] == P[j-k ~ j-1]
必然:T[i-k ~ i-1] == P[0 ~ k-1]
当模式字符串中在j处的字符跟目标字符串在i 处的字符匹配失败时,下一步用next[j]处的字符继续跟文本串i处的字符匹配,相当于模式串向右移动j - next[j]位。
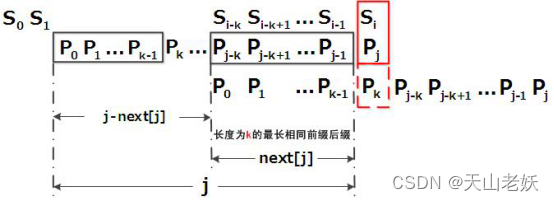
模式字符串查找的移位位数的规律:
A、模式字符串查找中,匹配失败时右移位数与模式字符串本身有关,与目标字符串无关。
B、移动的位数 = 已经匹配的字符数 - 对应的部分匹配值
C、任意子串都存在一个唯一的部分匹配表。
二、部分匹配表的生成
1、寻找前缀后缀最长公共元素长度
前缀:除了最后一个字符以外,一个字符串的全部头部集合。
后缀:除了第一个字符以外,一个字符串的全部尾部集合。
对于P = p0 p1 ...pj-1 pj,寻找模式串P中长度最大且相等的前缀和后缀。如果存在p0 p1 ...pk-1 pk = pj- k pj-k+1...pj-1 pj,那么在包含pj的模式串中有最大长度为k+1的相同前缀后缀。
部分匹配值:前缀和后缀的共有元素中最长元素的长度。
模式字符串的部分匹配表实例:
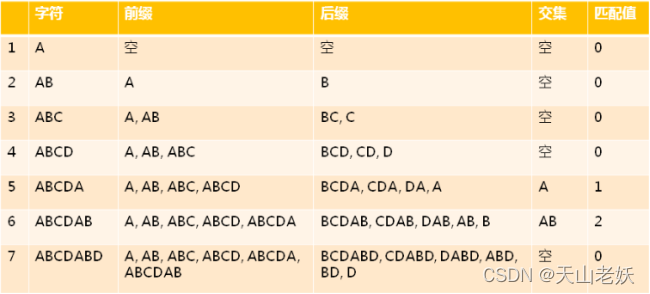
模式串子串对应的各个前缀后缀的公共元素的最大长度表为:
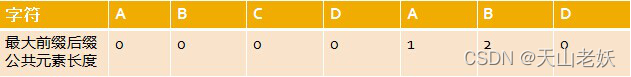
2、基于最大长度表的匹配过程
匹配失败时,模式串向右移动的位数为:已匹配字符数 - 失配字符的上一位字符所对应的最大长度值。
如果给定文本串“BBC ABCDAB ABCDABCDABDE”,模式串“ABCDABD”,匹配过程如下:
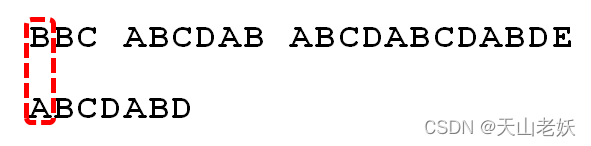
模式串中的字符A跟文本串中的字符B、B、C、空格一开始就不匹配,直接将模式串不断的右移一位即可,直到模式串中的字符A跟文本串的第5个字符A匹配成功,如下图:
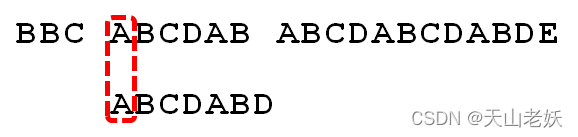
继续往后匹配,当模式串最后一个字符D跟文本串匹配失败时,模式串需要向右移动。此时已经匹配的字符数为6个(ABCDAB),然后根据《最大长度表》可得失配字符D的上一位字符B对应的最大长度值为2,可知需要向右移动6 - 2 = 4 位。如下图:
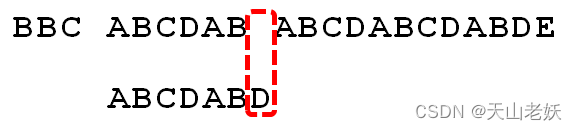
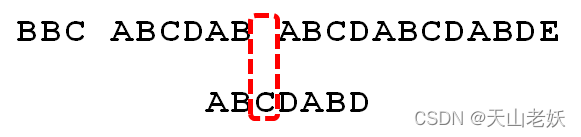
模式串向右移动4位后,发现文本串中的空格和模式串的C字符再度匹配失败,此时已经匹配了2个字符(AB),且上一位字符B对应的最大长度值为0,所以向右移动:2 - 0 =2 位。如下图:
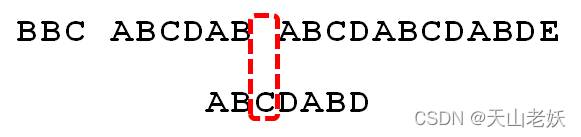
A与空格失配,向右移动1位。
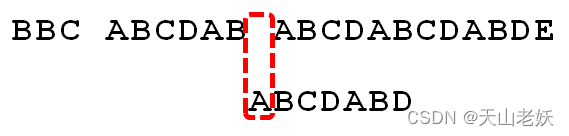
发现D与C 失配,故向右移动的位数为:已匹配的字符数6减去上一位字符B对应的最大长度2,即向右移动6 - 2 = 4 位。
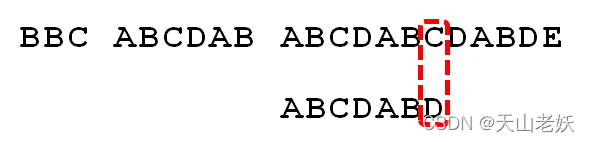
发现匹配成功,过程结束。
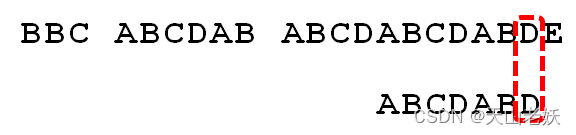
KMP算法的匹配过程可知,关键是寻找模式串中最大长度的相同前缀和后缀,找到模式串中每个字符之前的前缀和后缀公共部分的最大长度后,便可基于此匹配。最大长度便是next数组要表达的含义。
部分匹配值编程实现的关键:
A、下标为0的匹配值为0,PMT[0] = 0
B、从下标为1的字符开始递推
3、部分匹配表的递推过程
如果对于值k,已有p0 p1, ..., pk-1 = pj-k pj-k+1, ..., pj-1,相当于next[j] = k。next[j] = k代表p[j]之前的模式串子串中,有长度为k的相同前缀和后缀。在KMP匹配中,当模式串中j处的字符失配时,下一步用next[j]处的字符继续跟文本串匹配,相当于模式串向右移动j - next[j]位。
根据模式串“ABCDABD”的next 数组可知匹配失败位置的字符D对应的next 值为2,代表字符D前有长度为2的相同前缀和后缀(这个相同的前缀后缀即为“AB”),失配后,模式串需要向右移动j - next [j] = 6 - 2 =4位。
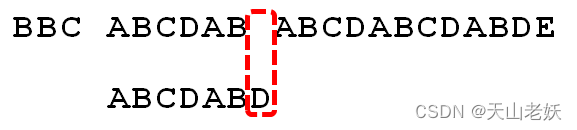
向右移动4位后,模式串中的字符C继续跟文本串匹配。
已知next [0, ..., j],如何递推next [j + 1]?
对于P的前j+1个序列字符:
若p[k] == p[j],则next[j + 1 ] = next [j] + 1 = k + 1;
若p[k ] ≠ p[j],如果此时p[ next[k] ] == p[j ],则next[ j + 1 ] = next[k] + 1,否则继续递归前缀索引k = next[k],而后重复此过程。 相当于在字符p[j+1]之前不存在长度为k+1的前缀"p0 p1, …, pk-1 pk"跟后缀“pj-k pj-k+1, …, pj-1 pj"相等,那么是否可能存在另一个值t+1 < k+1,使得长度更小的前缀 “p0 p1, …, pt-1 pt” 等于长度更小的后缀 “pj-t pj-t+1, …, pj-1 pj” 呢?如果存在,那么这个t+1 便是next[ j+1]的值,此相当于利用已经求得的next 数组(next [0, ..., k, ..., j])进行P串前缀跟P串后缀的匹配。
next[j]的值(也就是k)表示当P[j] != T[i]时,j指针的下一步移动位置。
当j为0时,如果不匹配,此时,j已经在最左边,不可能再向左回溯移动,此时i指针后移。
当j为1时,如果不匹配,j指针一定是向左回溯后移到0位置。
对于模式字符串ABCABCD,
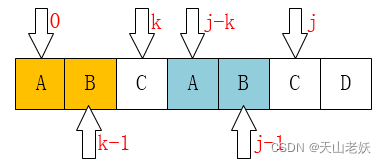
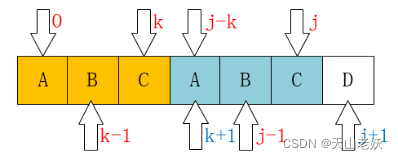
以上两图规律如下:
当P[k] == P[j]时,
有next[j+1] == next[j] + 1
证明如下:
因为P[0 ~ k-1] == p[j-k ~ j-1]。(next[j] == k)
如果P[k] == P[j],则P[0 ~ k-1] + P[k] == p[j-k ~ j-1] + P[j]。
即:P[0 ~ k] == P[j-k ~ j],即next[j+1] == k + 1 == next[j] + 1。
如果P[k] != P[j],
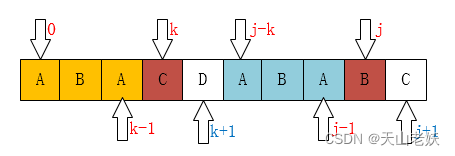
则k位置前面的k个字符和j位置前面的k个字符是匹配的,即
P[0 ~ k-1] == p[j-k ~ j-1]。(next[j] == k)
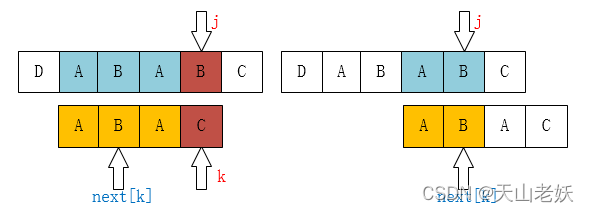
k = next[k];
4、部分匹配表的生成
部分匹配值的递推实现:
/****************************************
 *函数名称:生成部分匹配表
 *参数p:模式字符串
 ***************************************/
int* makePMT(const char* p)
{
    int len = strlen(p);
    //分配存储部分匹配表的值的数组空间
    int* ret = static_cast<int*>(malloc(len * sizeof(int)));
    if(ret)
    {
        //前缀和后缀的共有元素中最长元素的长度
        int ll = 0;
        //第1个字符的前缀和后缀都为空
        ret[0] = 0;
        //从第2个字符开始
        for(int j = 1; j < len; j++)
        {
            //如果前缀和后缀存在共有元素,
            while((ll > 0) && (p[ll] != p[j]))
            {
                //
                ll = ret[ll-1];
            }

            if(p[ll] == p[j])
              ll++;

            //部分匹配值
            ret[j] = ll;
        }
    }
    return ret;
}
三、KMP算法的实现
1、KMP算法的实现
/****************************************
 *函数名称:KMP子串查找算法
 *参数s:目标字符串
 *参数p:要查找匹配的模式字符串
 ***************************************/

int KMP(const char* s, const char* p)
{
    int ret = -1;
    int sLen = strlen(s);
    int pLen = strlen(p);
    //创建模式字符串的部分匹配表
    int* pmt = makePMT(p);
    if((pmt != NULL) && (0 < sLen) && (pLen <= sLen))
    {
        //遍历目标字符串,
        for(int i = 0, j = 0; i < sLen; i++)
        {
            //如果已经有字符匹配,并且s[i]和p[j]不匹配
            while((j > 0) && (s[i] != p[j]))
            {
                //i位置前的pmt[j-1]个字符已经与模式字符串的前pmt[j-1]个字符匹配
                j = pmt[j-1];//j回溯到pmt[j-1]处的字符继续比较
            }

            //如果字符匹配,继续逐位比较
            if(s[i] == p[j])
            {
                j++;
            }

            //如果找到匹配的字符串
            if(j == pLen)
            {
                //目标字符串中匹配的模式字符串的起始位置索引
                ret = i + pLen - 1;
                break;
            }
        }
    }

    free(pmt);
    return ret;
}
2、KMP算法的效率分析
如果文本串的长度为n,模式串的长度为m,那么匹配过程的时间复杂度为O(n),生成部分匹配表的时间为O(m),KMP的整体时间复杂度为O(m + n)。
更多推荐

 15
 0
- 0


 已为社区贡献6条内容

所有评论(0)