
pytorch使用data_prefetcher提升数据读取速度
·
直接给出代码:
class data_prefetcher():
    def __init__(self, loader):
        #loader 1:real
        #loader 2:fake
        self.stream = torch.cuda.Stream()
        self.loader = iter(loader)
        self.preload()

    def preload(self):
        try:
            self.next_input, self.next_target = next(self.loader)
        except StopIteration:
            self.next_input = None
            self.next_target = None
            return
        with torch.cuda.stream(self.stream):
            self.next_input = self.next_input.cuda(non_blocking=True).float()
            self.next_target = self.next_target.cuda(non_blocking=True).long()

    def next(self):
        torch.cuda.current_stream().wait_stream(self.stream)
        input = self.next_input
        target = self.next_target
        self.preload()
        return input, target
改造前:
- 代码
train_datasets = customData()
train_dataloaders = torch.utils.data.DataLoader(train_datasets,shuffle=True)
for data in train_dataloaders:
    current_iter += 1
    inputs, labels = data
- 训练用时
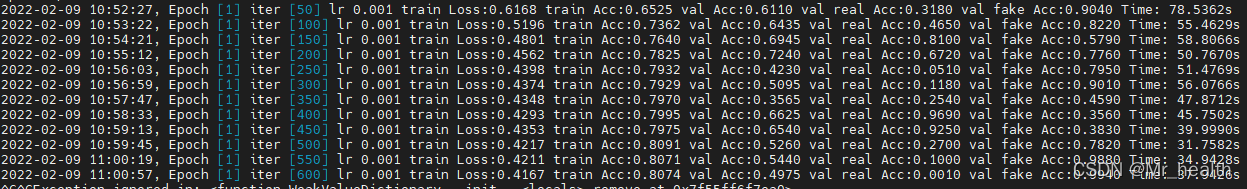
改造后:
- 代码
train_datasets = customData()
train_dataloaders = torch.utils.data.DataLoader(train_datasets,shuffle=True)
###增加
prefetcher = data_prefetcher(train_dataloaders)
###增加
inputs, labels  = prefetcher.next()
while inputs is not None:
    current_iter += 1
    inputs, labels  = prefetcher.next()
- 训练用时
更多推荐
 1
 0
- 0


 已为社区贡献6条内容

所有评论(0)