
用程序获取word页码方法汇总
·
背景说明
最近参与了一个档案管理系统,使用java开发,部署在centos,其中的一个功能需要获取到word文件准确的页码,现在将尝试过的方法汇总如下:
- Java Apache POI
- C# Microsoft.Office.Interop.Word.Application
- Python oletools (只支持doc)
- Python zipfile xml.etree.ElementTree (只支持docx)
Apache POI
由于系统是java开发的,所以首先尝试了poi,但是获取的页码不准确,所以这个方案放弃掉了。poi操作word的例子很多,这里就不上示例代码了。
C# Microsoft.Office.Interop.Word.Application
这种方法是能运行在windows上,直接上代码
public int GetWordPageCount(string filepath)
        {
            FileInfo f = new FileInfo(filepath);
            if (!f.Exists)
            {
                System.Console.WriteLine("打开文件失败");
                pageNum = -1;
                return -1;
            }
            string file_name = f.Name;
            string file_path = f.FullName;
            int pageCount = 0;

            Microsoft.Office.Interop.Word.Application app;

            app = new Microsoft.Office.Interop.Word.Application();
            app.Visible = false;

            object missing = System.Reflection.Missing.Value;
            object FileName = file_path;

            Microsoft.Office.Interop.Word.Document doc = null;

            try
            {
                doc = app.Documents.Open(ref FileName, ReadOnly: true);
                Microsoft.Office.Interop.Word.WdStatistic stat = Microsoft.Office.Interop.Word.WdStatistic.wdStatisticPages;
                pageCount = doc.ComputeStatistics(stat);//得到文档总页数
                pageNum = pageCount;

                doc.Close(Microsoft.Office.Interop.Word.WdSaveOptions.wdDoNotSaveChanges, ref missing);
                app.Quit(Microsoft.Office.Interop.Word.WdSaveOptions.wdDoNotSaveChanges, ref missing, ref missing);
                return pageCount;
            }
            catch (Exception ex)
            {
                app.Quit(Microsoft.Office.Interop.Word.WdSaveOptions.wdDoNotSaveChanges, ref missing, ref missing);
                System.Console.WriteLine(ex.Message);
                return -1;
            }
        }
这个方法需要使用做成dll,通过jni调用,将结果传给java。这个方法运行了一段时间后,运维反应还是有页数不对的,于是有了下一个方法。
Python oletools
上一个方法,由于C# Microsoft.Office.Interop.Word.Application只能在windows使用,所以还特意配了一台windows服务器,而使用oletools则可以运行在linux。
word文件本质上是一个ole文件,所以可以使用oletools工具包中的一个工具olemeta将信息读取到,meta是指word文件的元属性,如图
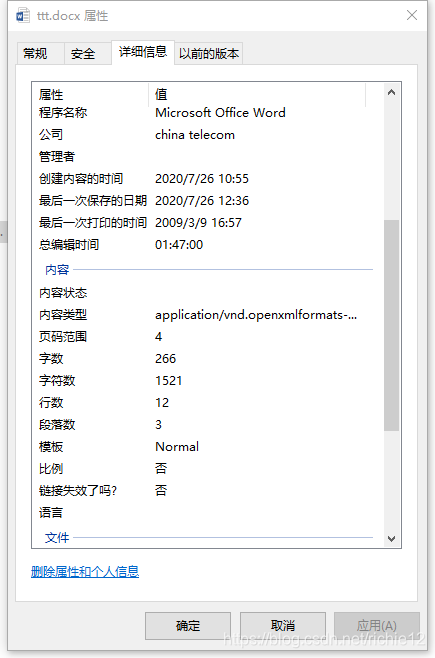 olemeta使用起来很简单,调用如下
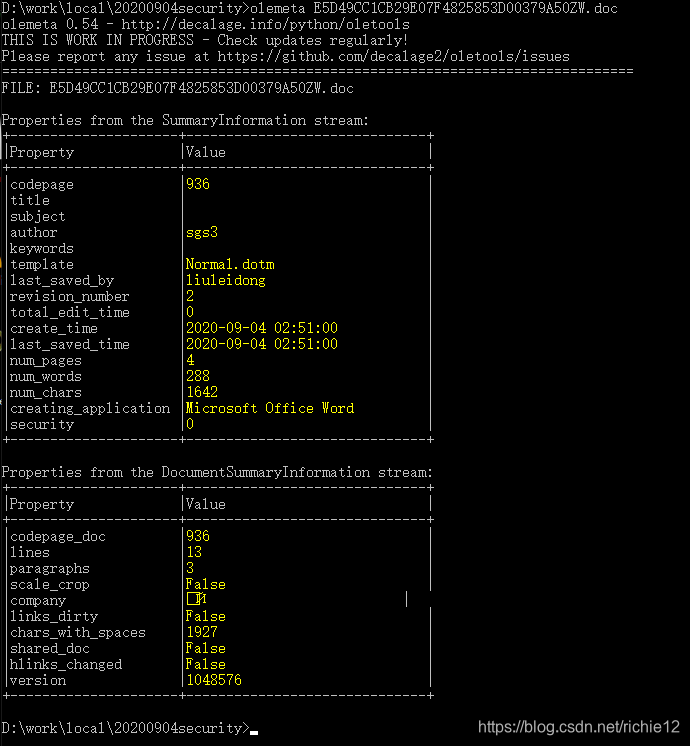
olemeta E5D49CC1CB29E07F4825853D00379A50ZW.doc
结果如下:
遇到的例外
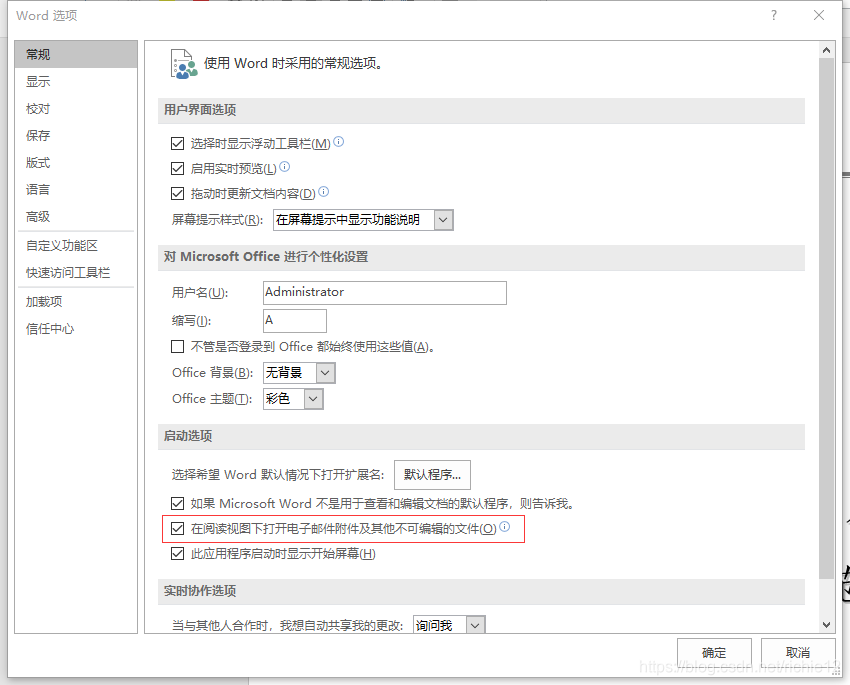
如果word中打开了阅读模式,如图,则olemeta获取的页码数是1
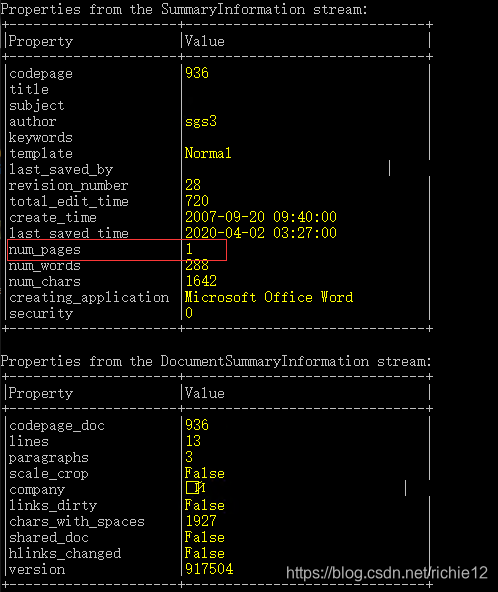
将文件另存为后,再次调用olemeta工具,就可以获取到正确的页码了。
Python zipfile xml.etree.ElementTree
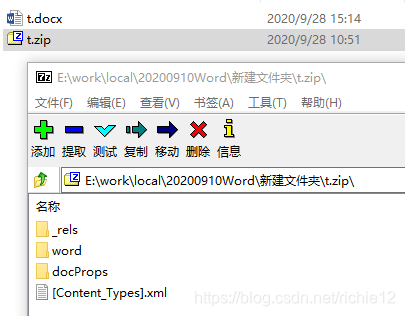
docx格式不是一个ole格式文件,所以不能够使用ole工具。docx实质上是一个压缩包,如图所示:
 其中,docProps/app.xml包含了页数属性,如图
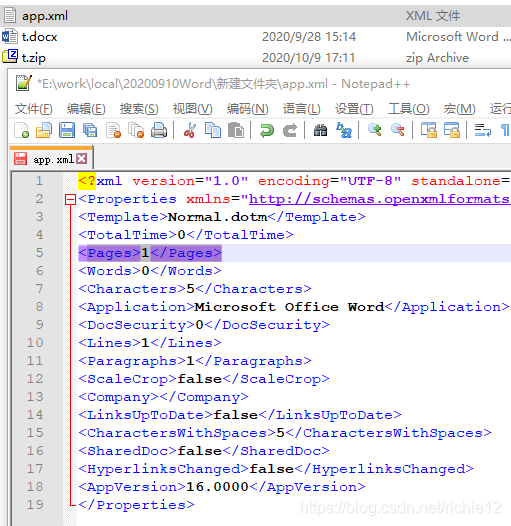 所以可以使用zipfile解压并且使用xml.etree.ElementTree解析xml然后获取页数属性,代码如下:
#!/usr/bin/env python

import sys, os, optparse
import zipfile
import xml.etree.ElementTree as ET

def getPages(filename):
    with zipfile.ZipFile('E:\\work\\local\\20200910Word\\t.docx') as docx:
        tree = ET.XML(docx.read('docProps/app.xml'))
        for child in tree:
            if(child.tag.find('Pages') != -1):
                print(child.text)

def main():

    usage = 'usage: docx <filename>'
    parser = optparse.OptionParser(usage=usage)

    (options, args) = parser.parse_args()

    # Print help if no arguments are passed
    if len(args) == 0:
        print(__doc__)
        parser.print_help()
        sys.exit()

    for filename in args:
        if filename.endswith('/'):
            continue
        getPages(filename)

if __name__ == '__main__':
    main()
总结
实践中,使用了oletools,zipfile和c#三种方法,首先使用python分别获取到doc和docx的页数,如果获取的页数是1,则使用c#方法再次计算。
更多推荐

 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)