
目标检测学习笔记(三)SSD算法
参考视频: (全)最好的目标检测原理与实践课程
参考目录: 计算机视觉应用实战-网易云课堂
参考文章:
- 目标检测 | 清晰易懂的SSD算法原理综述
- SSD原理解读-从入门到精通
- 一文读懂目标检测:R-CNN、Fast R-CNN、Faster R-CNN、YOLO、SSD
- 详述目标检测最常用的三个模型:Faster R-CNN、SSD和YOLO
本次笔记仅做补充理解作用,对于SSD的绝大部分理解都参考以上文章中的链接,大佬写的很深入,避免了我重复造轮子
传送门
目标检测算法中的one-stage和two-stage
Two-stage:Faster-RCNN two-stage检测算法将检测问题划分为两个阶段,首先产生候选区域(region proposals),然后对候选区域分类(一般还需要对位置精修)。特点是:错误率低,漏识别率也较低,但速度较慢,不太能满足实时检测场景。
One-stage:SSD,YOLO不需要region proposal阶段,可以直接产生物体的类别概率和位置坐标值,经过单次检测即可直接得到最终的检测结果。
特点:有着更快的检测速度。
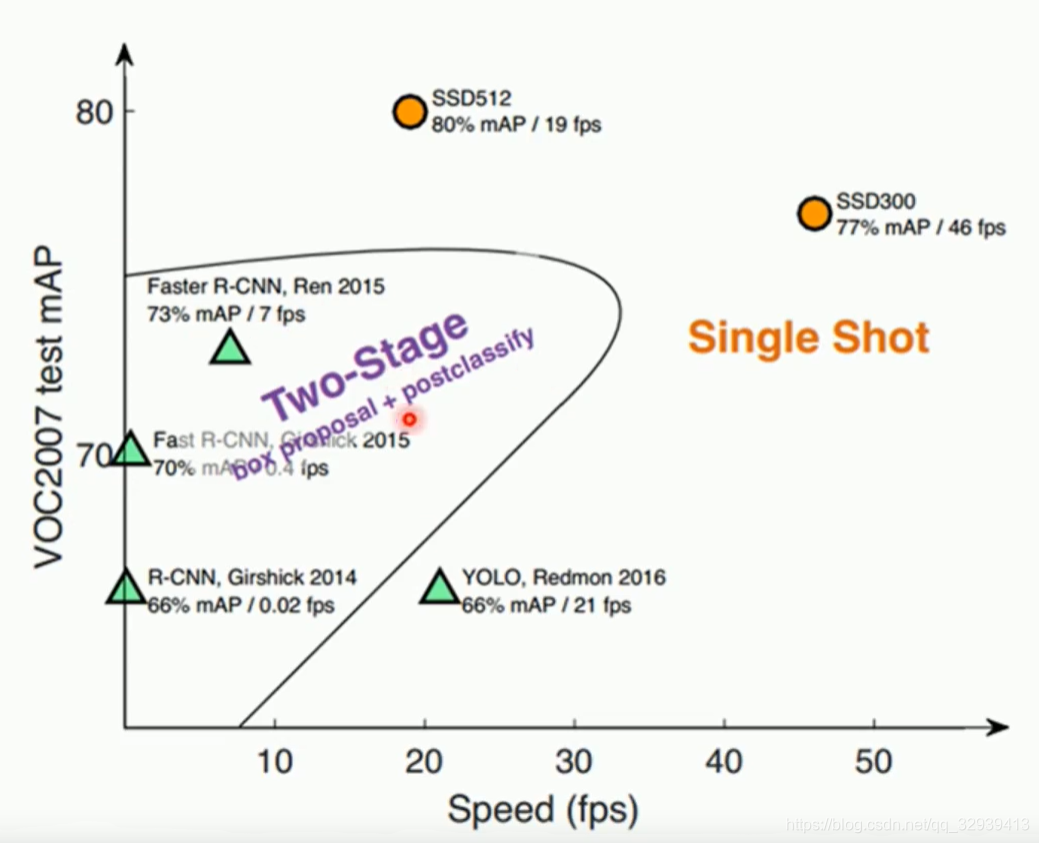
SSD(single shot multibox detector)
SSD模型结构
SSD算法是2016年推出的一-种 目标检测模型,算法的主网络结构是VGG16。
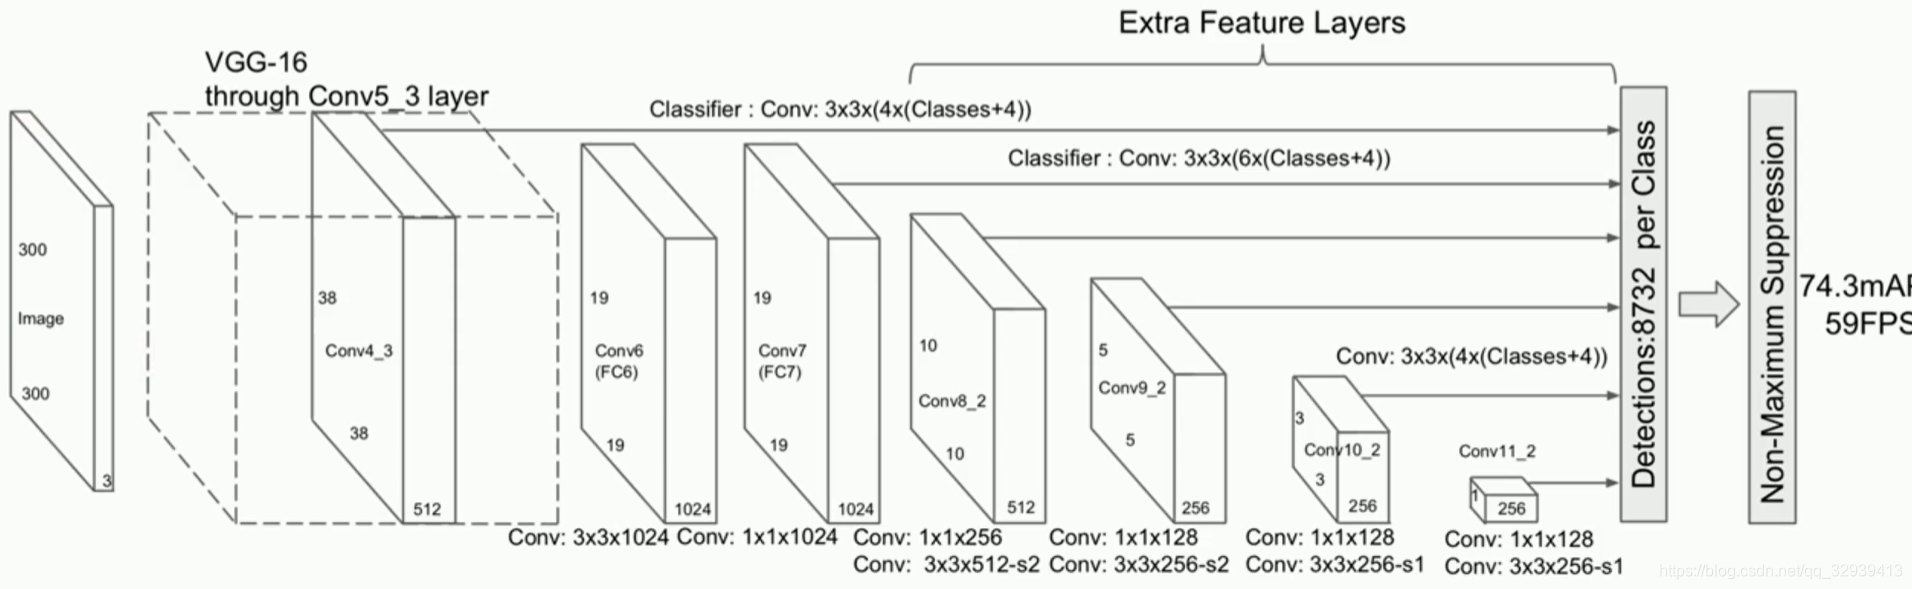
Conv:3×3×512-s2 表示 卷积核3×3,数量512,步长2;
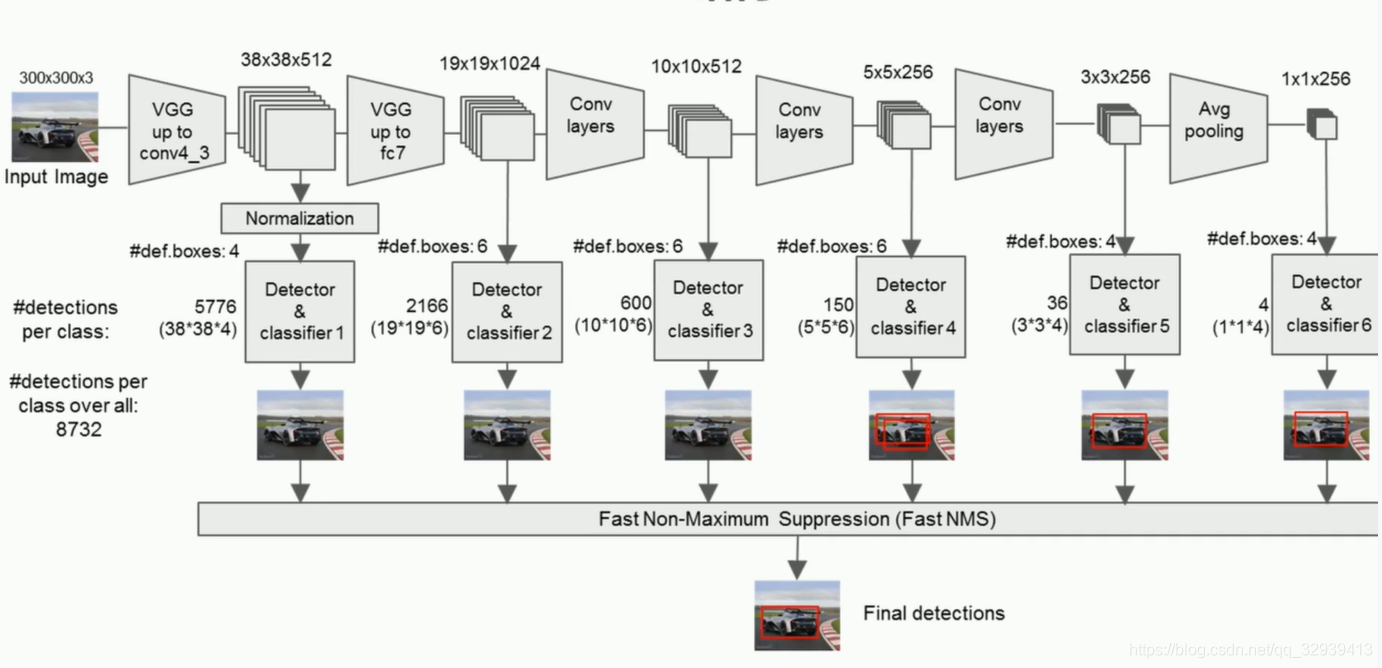
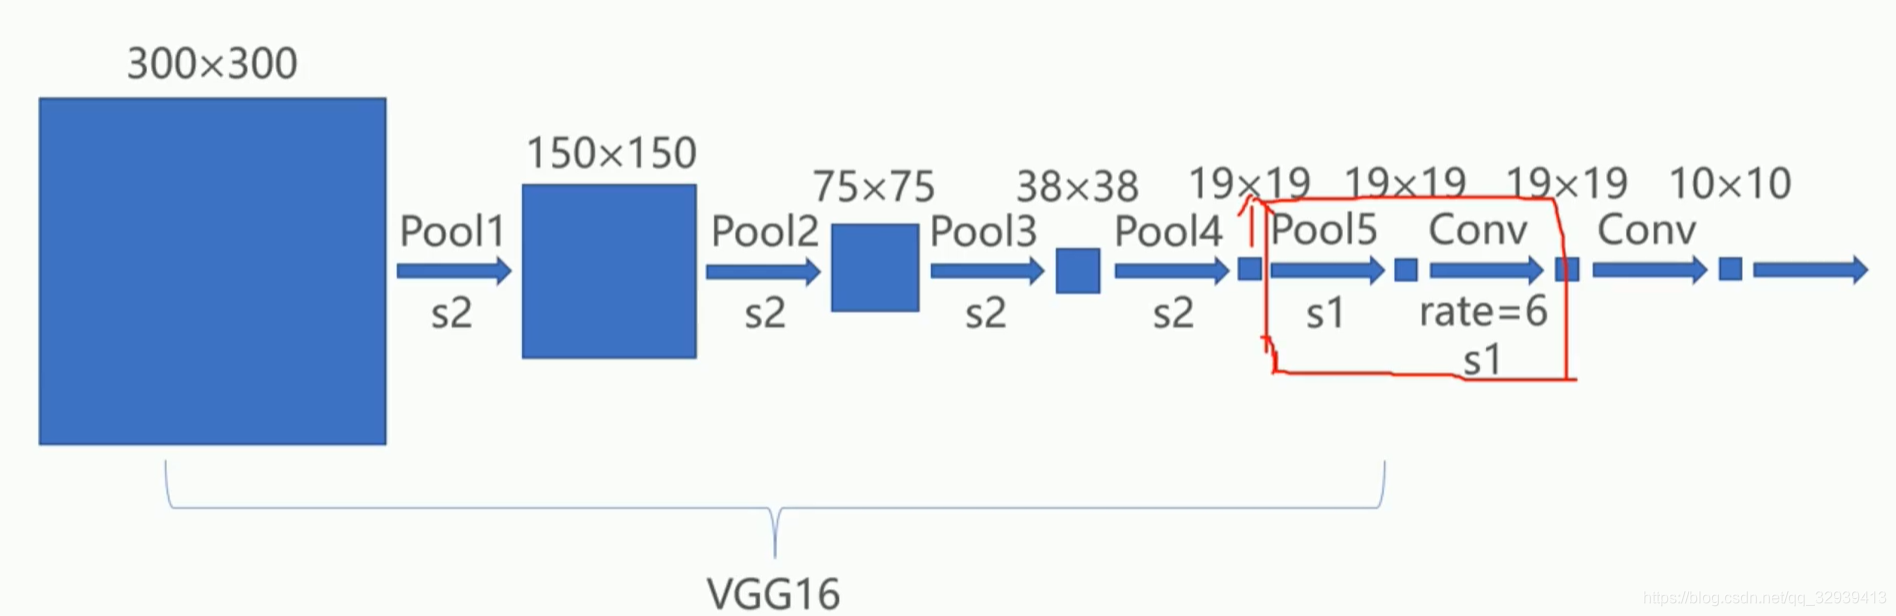
在第五个池化后进行了空洞卷积操作,扩张率6,作用是不让特征图变的太小,从而提高感受野,使小特征能够被提取。
SSD特征金字塔
左边的方法针对输入的图片获取不同尺度的特征映射,但是在预测阶段仅仅使用了最后一层的特征映射;
而SSD不仅获得不同尺度的特征映射,同时在不同的特征映射,上面进行预测,它在增加运算量的同时可能会提高检测的精度,因为它考虑了更多尺度的特征。
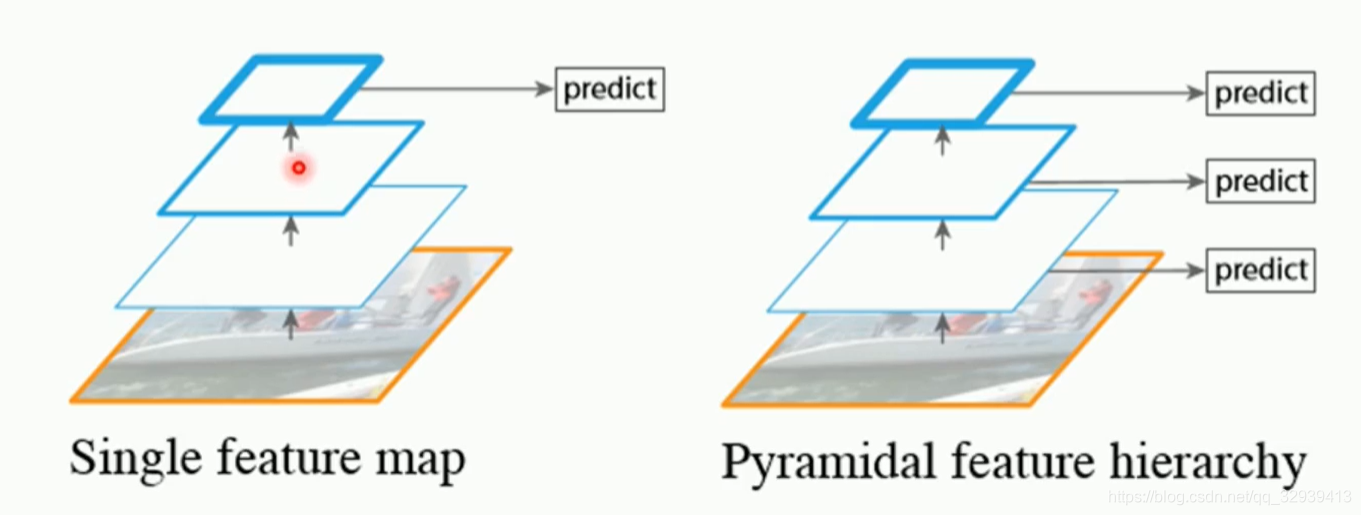
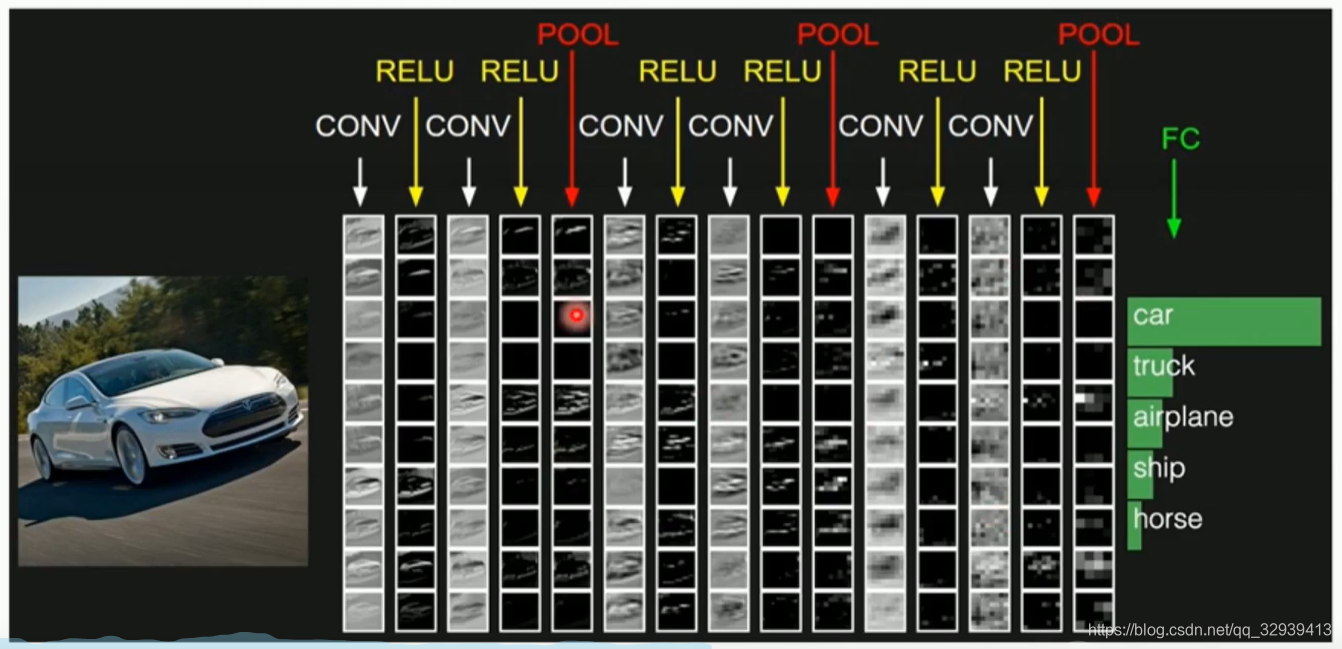
下图中我们可以看到在不同的卷积层会输出不同大小的feature map(这是由于pooling层的存在,它会将图片的尺寸变小),而且不同的feature map中含有不同的特征,而不同的特征可能对我们的检测有不同的作用。总的来说,浅层卷积层可以得到物体边缘信息,而深层网络可以得到更细节更抽象的特征。
SSD代价函数和Match策略
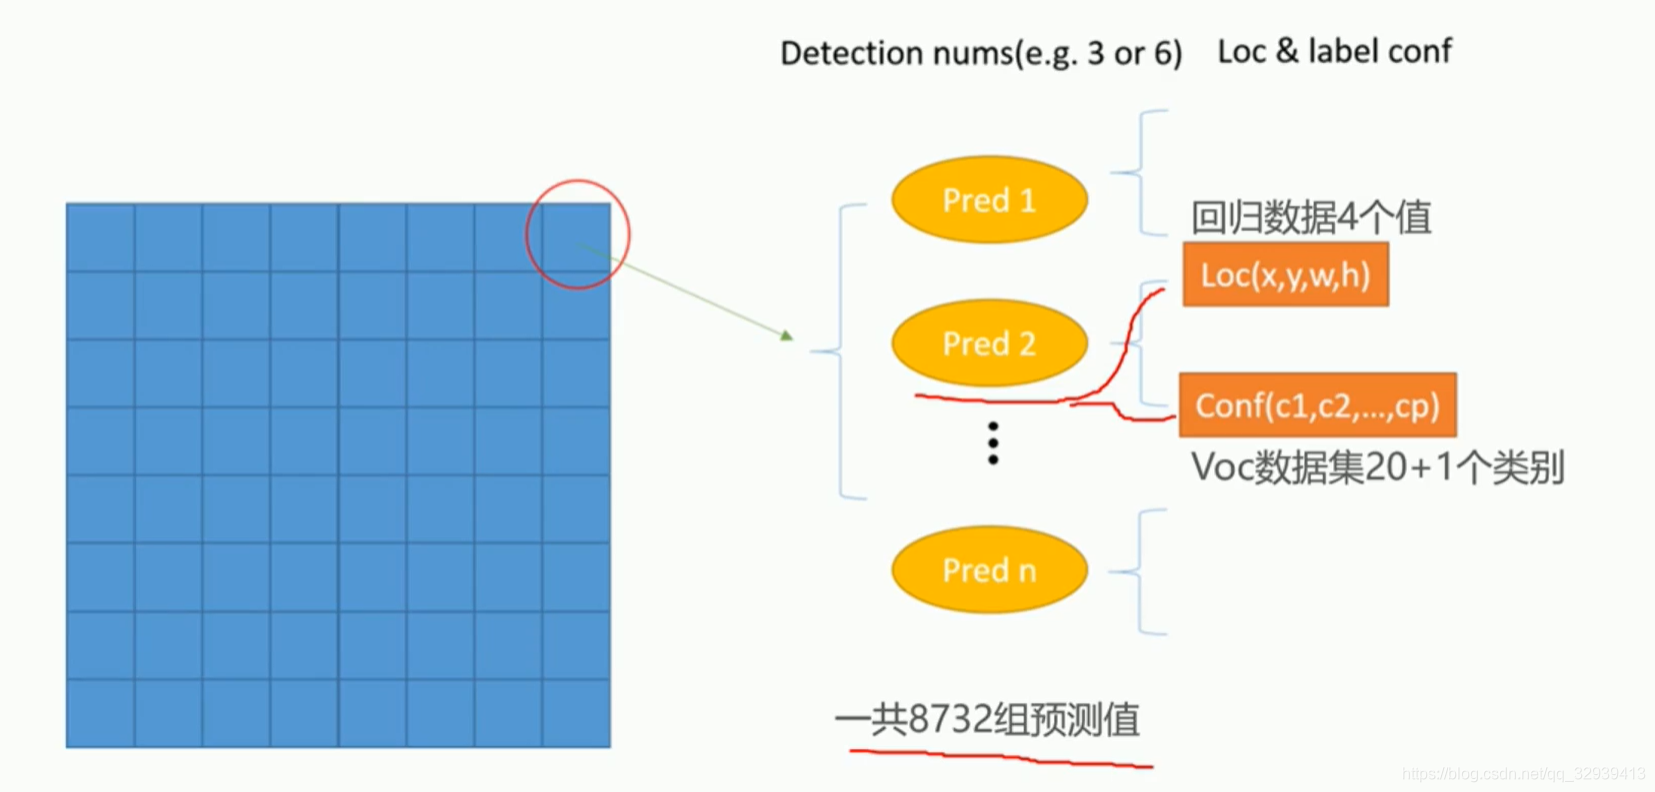
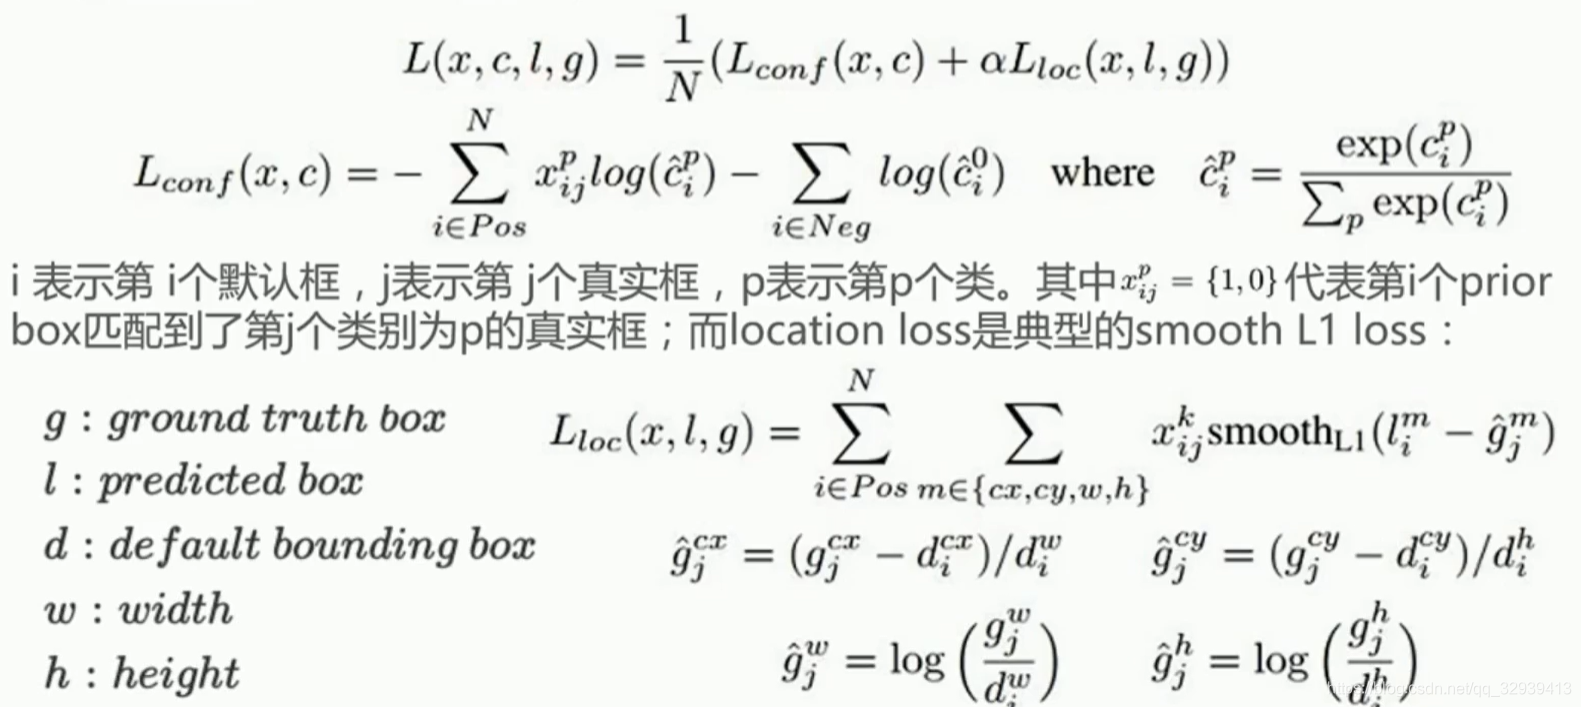
SSD算法的目标函数分为两部分:计算相应的预选框与目标类别的confidence loss以及相应的位置回归。
其中N是match到Ground Truth的预选框数量;而α参数用于调整confidence loss和location loss之间的比例,默认α =1。
Match策略:
在训练时,groundtruth boxes与prior boxes按照如下方式进行配对:
- 首先,寻找与每一个ground truth box有最大的交并比(loU)的prior box,这样就能保证每一个groundtruth box与唯一的一-个prior box对应起来。
- SSD之后又将剩余还没有配对的prior box与任意一个groundtruth box尝试配对,只要两者之间的交并比(loU)大于阈值,就认为match(SSD 300阈值为0.5)。
- 显然配对到GT的prior box就是positive,没有配对到GT的prior box就是negative。
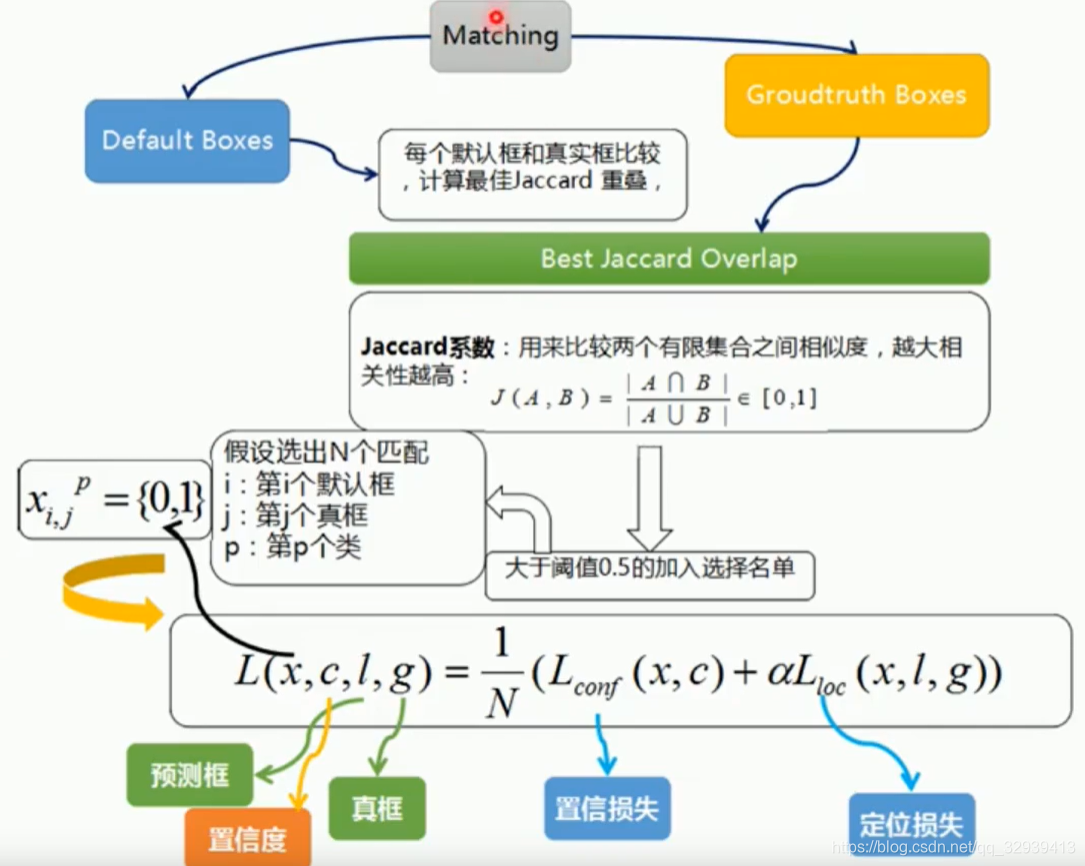
prior boxes即预选框,又叫默认框;
Jaccard即交并比,IOU;
Hard negative mining & Data augmentation
Hard negative mining: 值得注意的是,一般情况下negative default boxes数量> > positive default boxes数量直接训练会导致网络过于重视负样本,从而loss不稳定。所以SSD在抽样时按照置信度误差(预测背景的置信度越小,误差越大)进行降序排列,选取误差的较大的top-k作为训练的负样本,控制positive:negative=1:3。
作者发现这可以导致模型更快的优化和更稳定的训练。
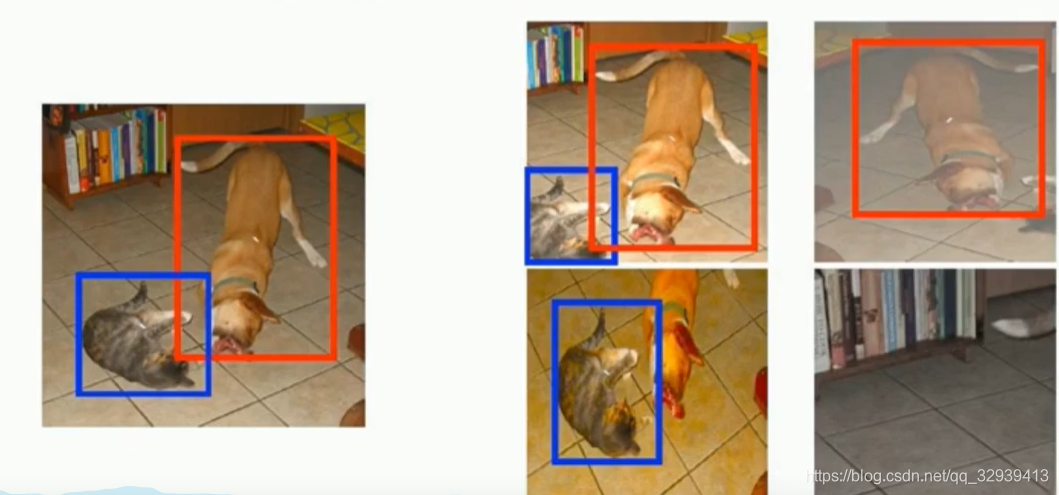
Data augmentation(数据增广):
为了使模型对于各种输入对象大小和形状更加鲁棒,每个训练图像通过以下选项之一随机采样:
- 使用整个原始输入图像
- 采样一个区域,使采样区域和原始图片最小的交并比重叠为0.1,0.3,0.5,0.7或0.9。
- 随机采样一个区域
每个采样区域的大小为原始图像大小的[0.1,1],长宽比在1/2和2之间。如果真实标签框中心在采样区域内,则保留两者重叠部分作为新图片的真实标注框。在上述采样步骤之后,将每个采样区域大小调整为固定大小,并以0.5的概率水平翻转。
SSD算法结果分析
-
同样的数据集SSD比Faster R-CNN更好
-
更多的训练数据可以得到更好的结果
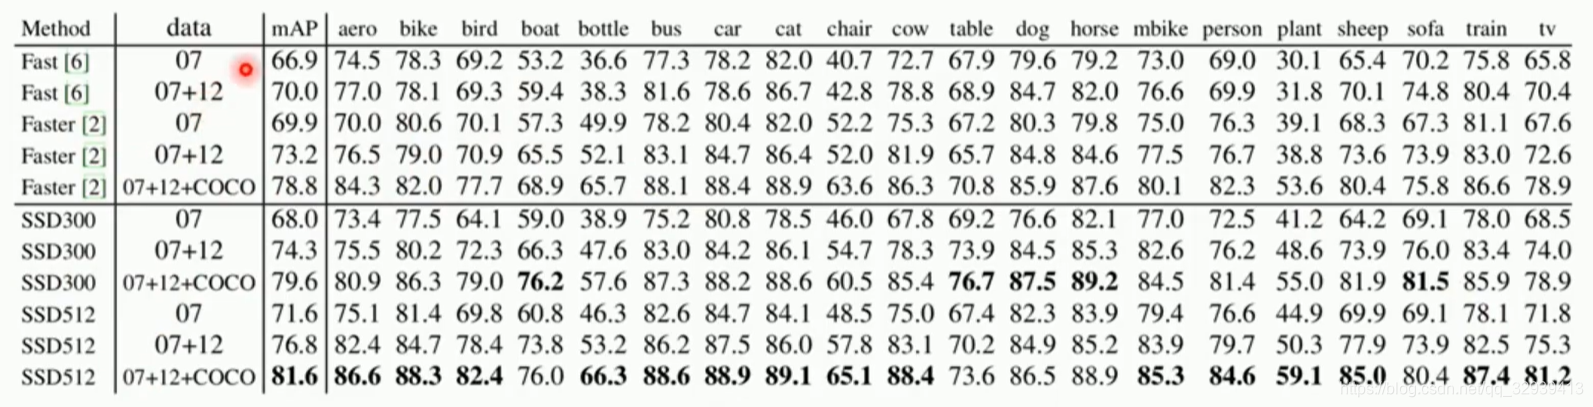
Table 1: PASCAL VOC2007 test detection results. Both Fast and Faster R -CNN use input images whose minimum dimension is 600. The two SSD models have exactly the same settings except that they have different input sizes (300x 300vs.512x512). It is obvious that larger input size leads to better results, and more data always helps. Data:
“07”: VOC2007 trainval,“07+ 12”: union of VOC2007 and VOC2012 trainval.“07+12+COCO”: first train on COCO trainval35k then fine-tune on 07+ 12. -
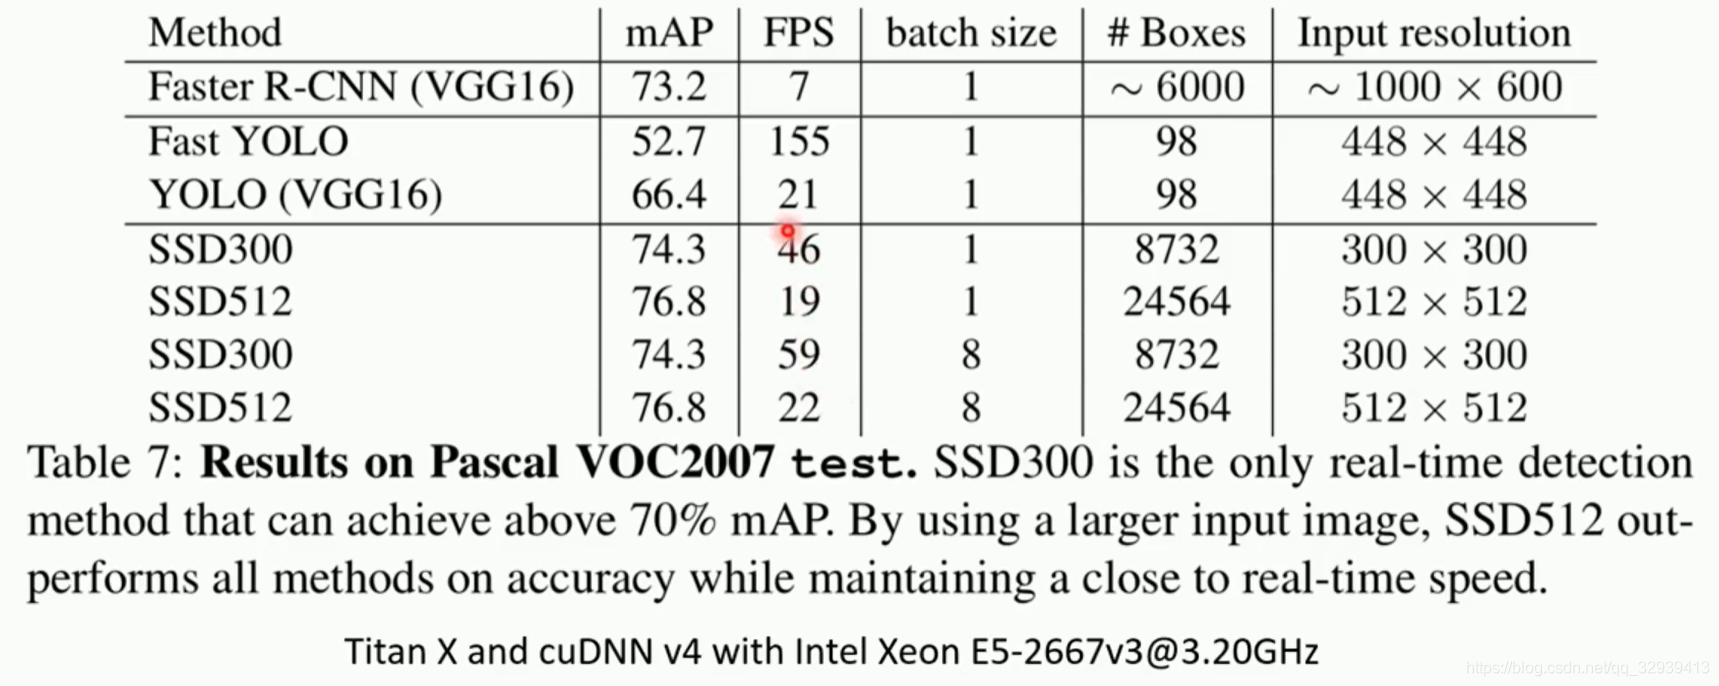
SSD512可以得到更好的检测结果
-
SSD300拥有更好的检测实时性
-
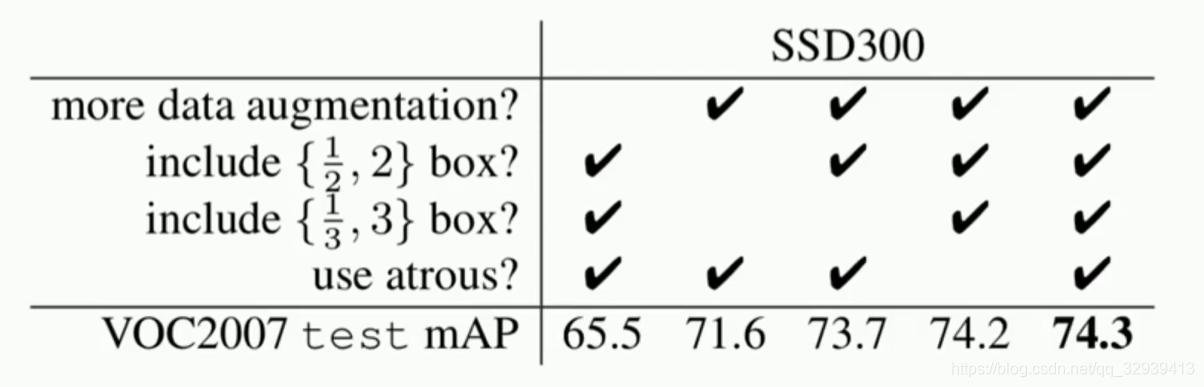
数据增强(Data augmentation)对于结果的提升非常明显
-
使用更多的default boxes,结果也越好
-
Atrous(空洞卷积)使得SSD效果更好
-
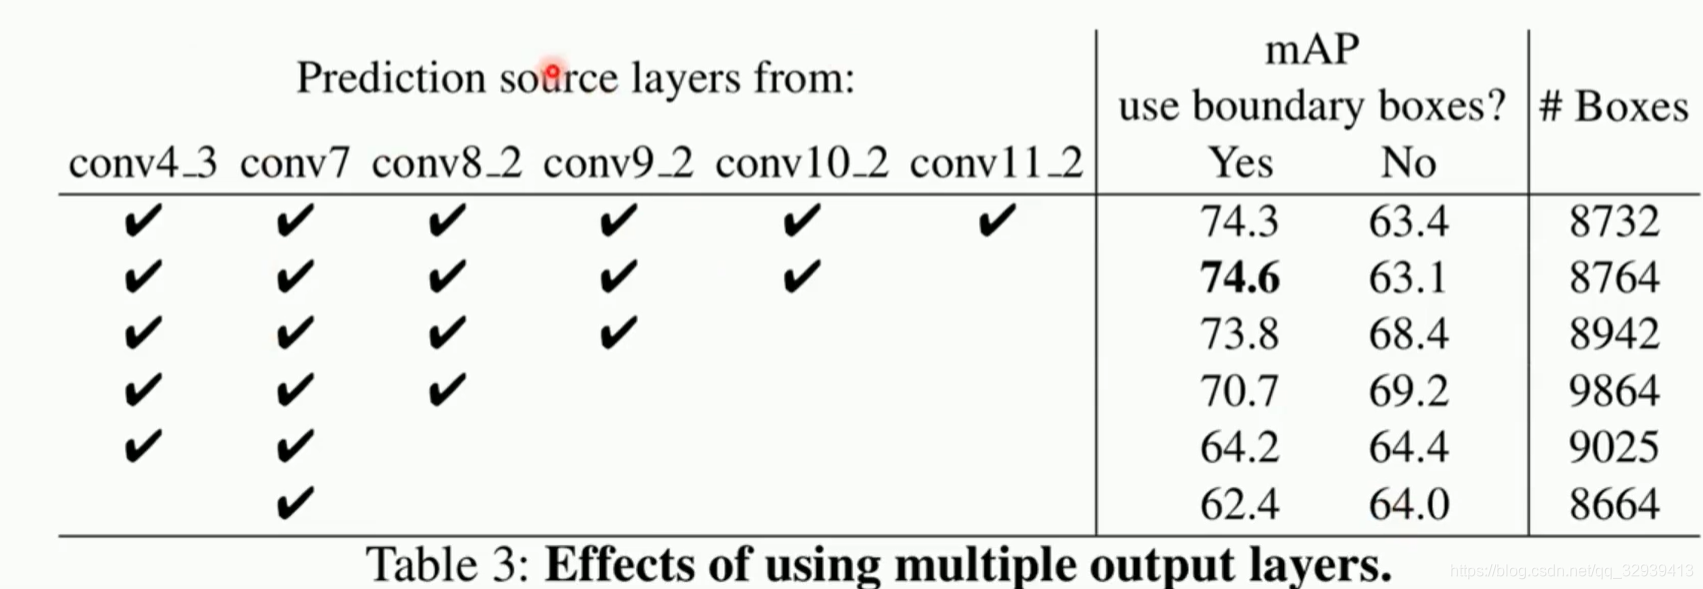
更多的feature map可以得到更好的结果
-
使用图片边界的标注框比不使用图片边界的标注框效果更好
SSD缺点
- 需要人工设置prior box的min_size,max_size和aspect ratio值。网络中预选框的基础大小和形状需要手工设置。而网络中每一层feature使用的预选框大小和形状不一 样,导致调试过程非常依赖经验。
- 虽然采用了特征金字塔的思路,但是对小目标的识别效果依然一般,可能是因为SSD使用conv4__3低级feature去检测小目标,而低级特征卷积层数少,存在特征提取不充分的问题。
更多推荐



 0
 0
- 0


 已为社区贡献4条内容

所有评论(0)