
学习笔记--目标检测3 SSD
文章目录
0、归纳
本文提出了多尺度检测方法、去掉网络里的全连接层,用卷积检测,使用不同的先验框策略,分别利用分类和定位的损失函数,还是用到了空洞卷积,得到了更快精度还不错的结果
1、学习目标
整体框架
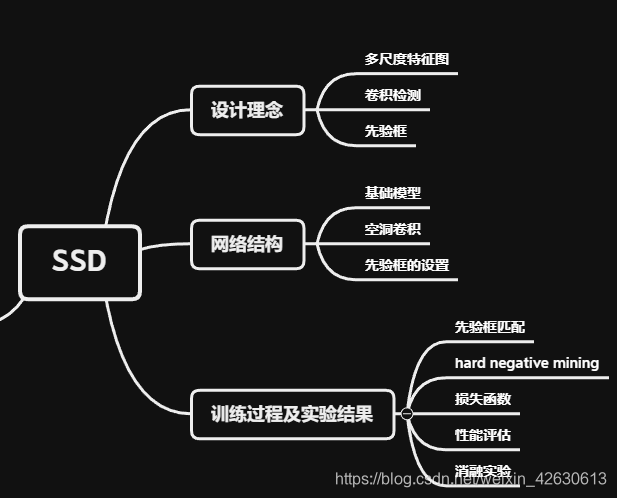
SSD直接采用卷积对不同的特征图来进行提取检测结果,直接使用卷积输出作为回归(定位)和分类预测(分类)
创新
1、多尺度特征图
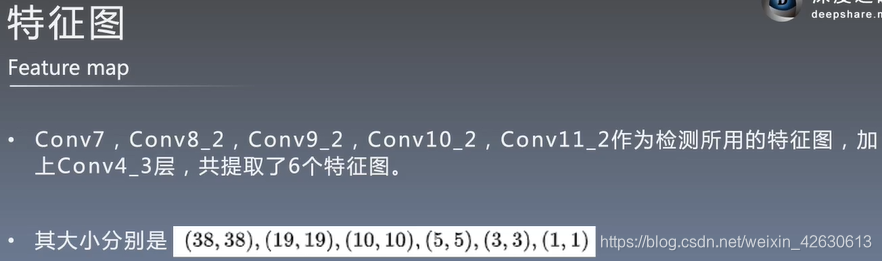
特征提取层4-3作为第一个单独的特征图输出(38,38),其余5个一起输出
2、不同于其他方法的先验框
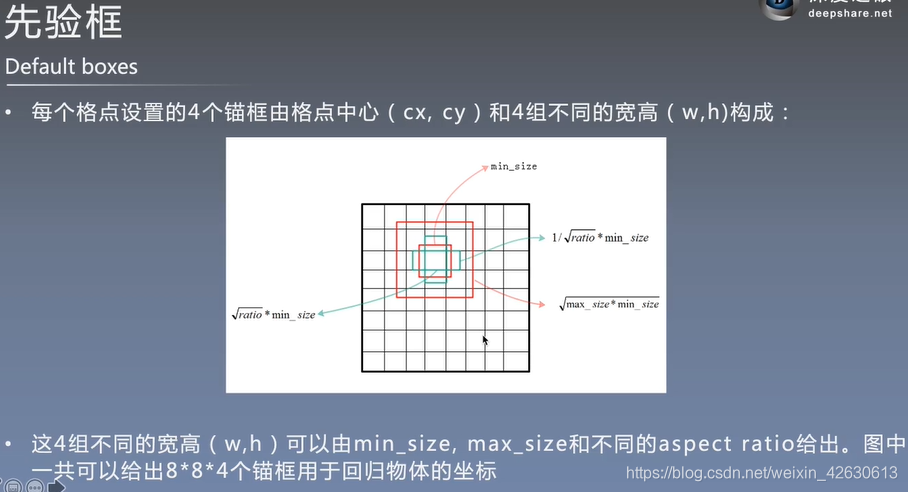
1、此处的先验框是怎样的?
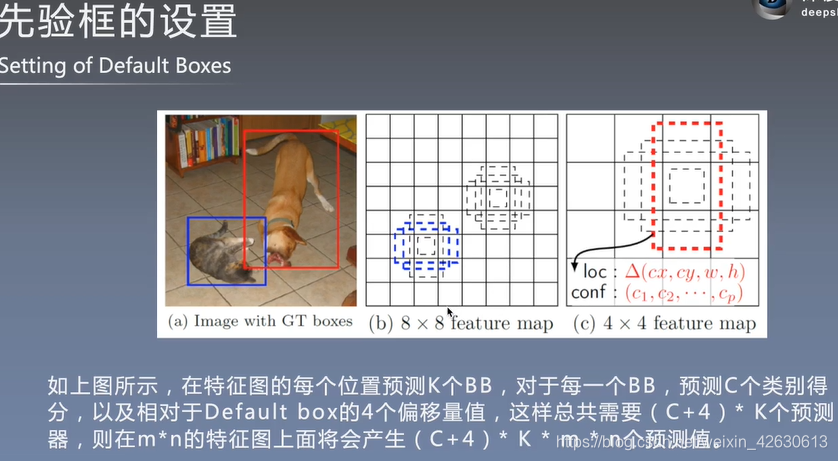
每个格点设置的4个anchor由格点中心和4组不同的宽和高构成,4组宽高由一些值(min_size、max_size、aspect ratio)决定
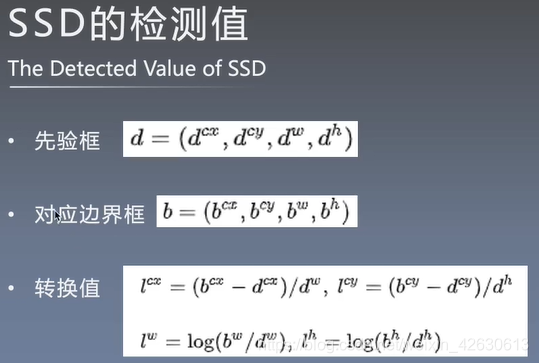
2、SSD检测:
先验框经过转换值转换到对应的bounding box,即编码,否则为解码
atrous算法:空洞卷积
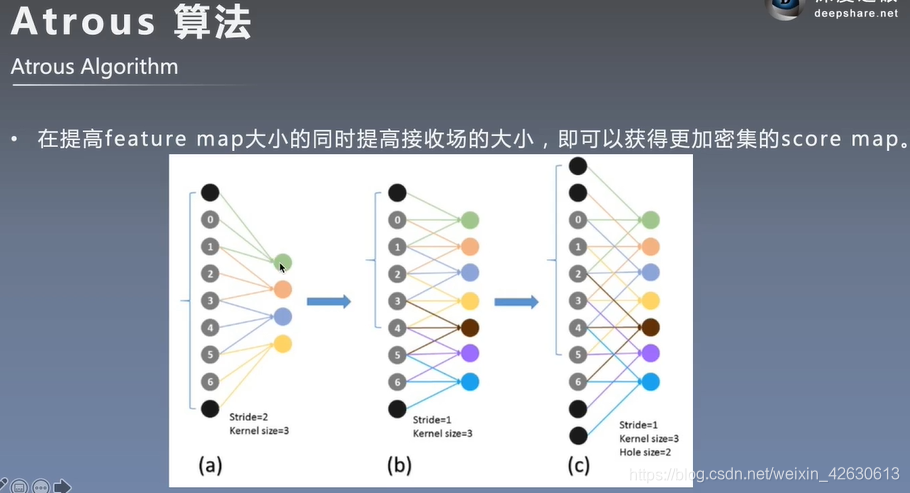
插曲:空洞卷积:不增加参数量(即神经元之间的连接),却能扩大视野
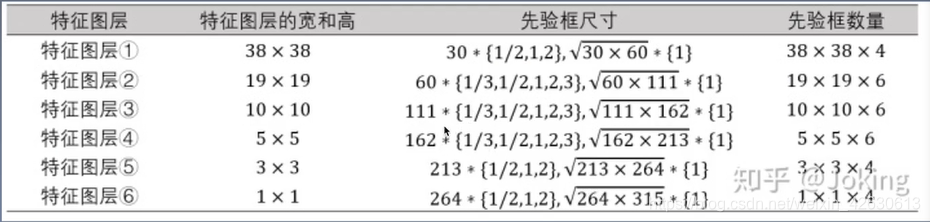
3、先验框的设置
把RPN计算的结果集成到一阶段网络,
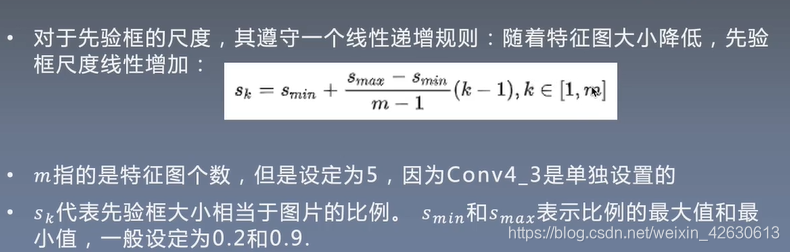
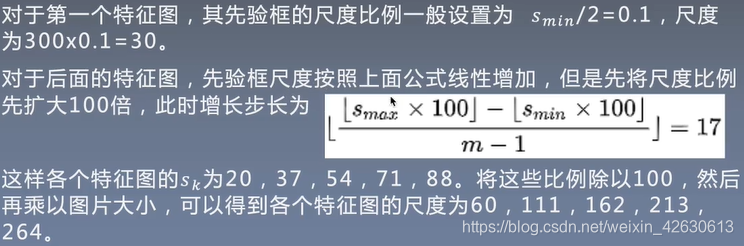
注:sk是相对于原图(300)的比例
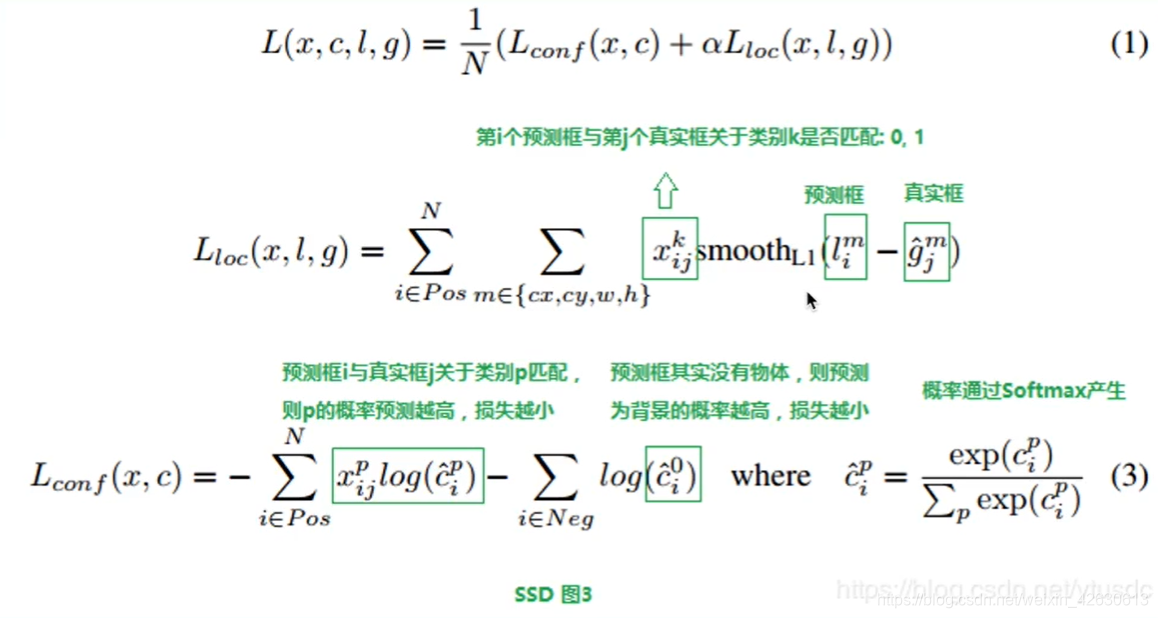
损失:定位误差与分类误差的加权和L
location位置、其实指针对于正样本,负样本就为0了
先验框的位置、
置信度的损失、
注意:smooth loss在faster RCNN里也有
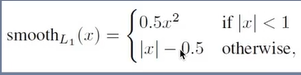
4、先验框匹配


GT很少,8000+的先验框,因为负样本比较多,可能没人匹配的都匹配到负样本去了,这样找到的负样本太多了
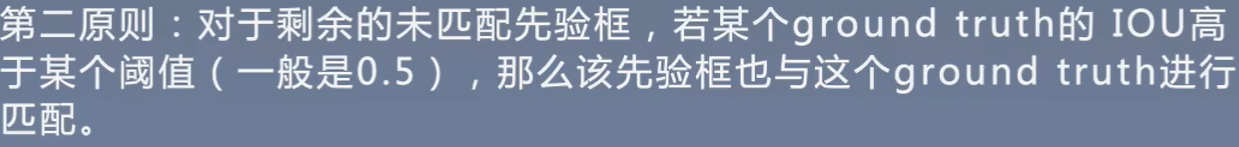
原则2会增加正样本的数量
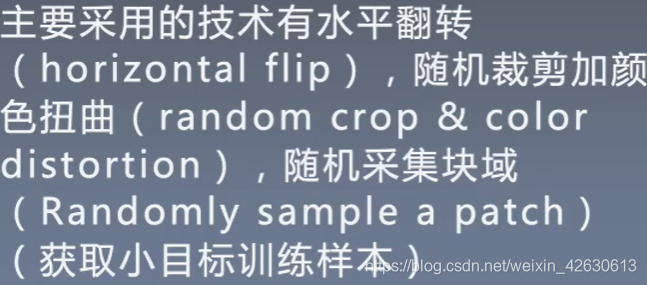
5、数据增强
3、hard negative mining–tricks
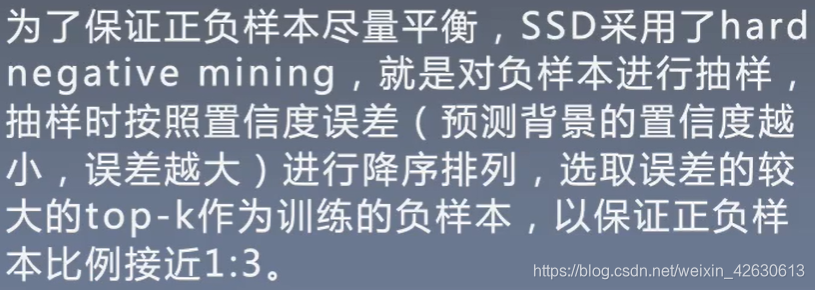
选择一部分负样本去进行
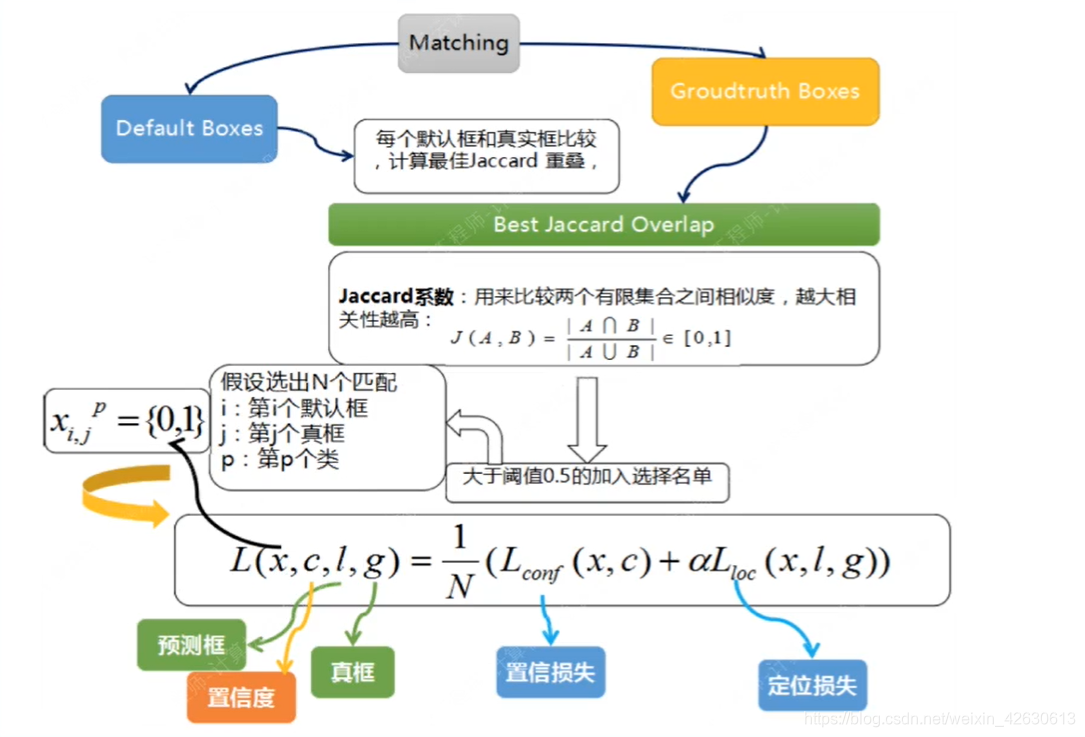
先判断出正负样本
x是个指示参数,看看是否匹配上
4、预测
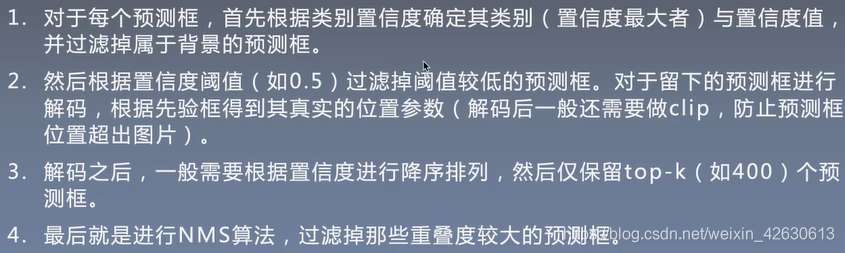
1、过滤背景–2、过滤低阈值–3、解码(Bbox按公式转为预测框)–4、再删选(排序,去重)
解码和编码的含义:先验框经过转换值转换到对应的bounding box,即编码,否则为解码
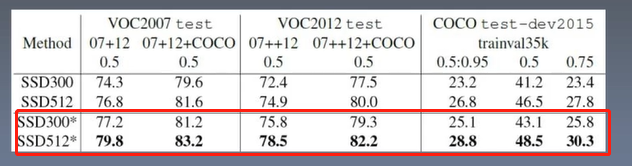
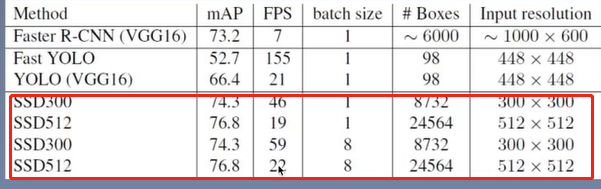
5、性能
mAP是训练,FPS是测试求的。
输入尺寸大点的话,结果会好点
batchsize大小对mAP没影响,但是FPS还是有的
是否用数据增强、
是否用空洞卷积
都用会好一点,不用空洞卷积会差一点点,不追求极限性能的话可能不需要也行,加上会更好
不用数据增强会差很多
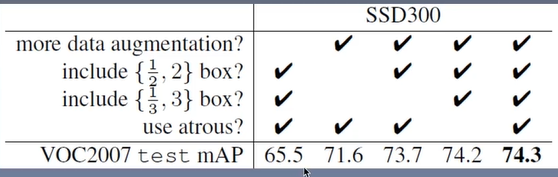
是否用边界上那个不完整的框,用的话结果会好一些
6、比较faster RCNN,yolo1
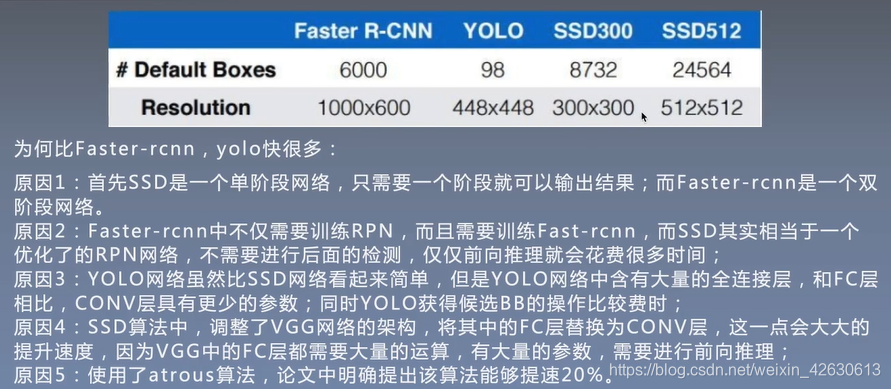
单阶段、FC层、空洞卷积、
mAP提升有限,但是速度很快
7、启发点
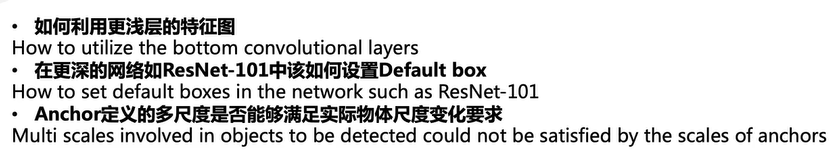
1、为何是用4-3的特征图而不是更浅的,是否可以用其他方法提高mAP
2、代码部分
Dataset是读取一些数据,(自己定义,初始化、数据集的量、需要取得ID)
并对数据做一些变换transform,然后Dataloader是对数据进行加载
verse操作的数据增强?Bbox坐标值换一下,横坐标或者纵坐标–用在随即翻转的实现中
随机裁剪–会裁剪到边界,要注意,另外,裁剪可能吧Bbox裁剪没了,也要做判断
anchor=default box=priorbox
了解数据流
更多推荐

 0
 0
- 0


 已为社区贡献3条内容

所有评论(0)