
神经网络学习(一)(pytorch)
pytorch实现线性回归
w = Variable(torch.randn(1),requires_grad=True)   #需要求梯度
b = Variable(torch.randn(1),requires_grad=True)

def linear_model(x):
    return w*x+b
def get_loss(y_,y):
    return torch.mean((y_-y)**2)

loss.backward()

w.data = w.data - 1e-2 * w.grad.data   #w.data表示取w的数据
b.data = b.data - 1e-2 * b.grad.data   #学习率

for e in range(10)    #进行10次更新
    y_ = linear_model(x_train)
    loss = get _loss(y,y_train)

    w.grad.zero_()  #归零梯度
    b.grad.zero_()  #归零梯度
    loss.backward()
    w.data = w.data - 1e-2 * w.grad.data  #更新w
    b.data = b.data - 1e-2 * b.grad.data  #更新w
    print('epoch:{},loss:{}'.formate(e,loss.data[0]))
线性模型和梯度下降
import torch
import numpy as np
from torch.autograd import Variable

torch.manual_seed(2017)

#读入数据x和y
x_train = np.array([3.3],[4.4],[5.5],[6.71][6.93],[4.168],[9.779],[6.182],dtype=np.float32)
y_train = np,array([1.7],[2.76],[2.09],[3.19],[1.649],[1.573],[3.366],
                   [2.596]dtype=np.float32)

#画出图像
import matplotlib.pyplot as plt
%matplotlib inline

plt.plot(x_train,y_train,'bo')
#转换成Tensor
x_train = torch.from_numpy(x_train)
y_train = torch.from_numpy(y_train)

#定义参数w和b
w = Variable(torch.randn(1),requires_grad=True) #随机初始化
b = Variable(torch.zeros(1),rewuires_grad=True) #使用0进行初始化
#构建线性回归模型
x_train = Variable(x_train)
y_train = Variable(y_train)
def linear_model(x)
    return w * x + b
y_ = linear_model(x_train)
以上步骤就定义好了迷行,在进行参数更新前,可以先看看模型的输出结果
plt.plot(x_train.data.numpy(),y_train.data.numpy(),'bo',label='real')
plt.plot(x_train.data.numpy(),y_.data.numpy(),'ro',label='estimated')
plt.legend()

#计算误差
def get_loss(y_,y):
    return torch.mean((y_ - y_train) ** 2)
loss = get_loss(y_,y_train)
print(loss)
#计算w和b的梯度
loss.backward()
#查看w和b的梯度
print(w.grad)
print(b.grad)
#更新一次参数
w.data = w.data - 1e-2 * w.grad.data
b.data = b.data - 1e-2 * b.grad.data
更新完参数之后,看一下模型输出的结果
y_ = linear_model(x_train)
plt.plot(x_train.data.numpy(),y_train.data.numpy(),'bo',label='real')
plt.plot(x_train.data.numpy(),y_.data.numpy(),'ro',label='estimated')
plt.legend()

for e in range(10)    #进行10次更新
    y_ = linear_model(x_train)
    loss = get _loss(y,y_train)

    w.grad.zero_()  #归零梯度
    b.grad.zero_()  #归零梯度
    loss.backward()
    w.data = w.data - 1e-2 * w.grad.data  #更新w
    b.data = b.data - 1e-2 * b.grad.data  #更新w
    print('epoch:{},loss:{}'.formate(e,loss.data[0]))
y_ = linear_model(x_train)
plt.plot(x_train.data.numpy(),y_train.data.numpy(),'bo',label='real')
plt.plot(x_train.data.numpy(),y_.data.numpy(),'ro',label='estimated')
plt.legend()

多项式回归模型:
#定义一个多变量函数

w_target = np.array([0.5,3,2.4])  #定义参数
b_target = np.array([0.9]) #定义参数

f_des = 'y = {:.2f} + {:.2f} * x + {:.2f} * x^2 + {:.2f} * x^3.format(b_target[0],w_target[1],w_target[2])  #打印出函数的式子

print(f_des)
#画出函数曲线
x_sample = np.arange(-3,3.1,0.1)
y_sample = b_target[0] + w_target[0] * x_sample +w_target[1] * x_sample ** 2 + w_target[2] * x_sample ** 3

plt.plot(x_sample,y_sample,label='real curve')
plt.legend()
# 构建数据x和y
# x 是一个如下矩阵[x,x^2,x^3]
# y是函数的结果[y]
x_train = np.stack([x_sample ** i for i in range(1,4)],axis=1)
x_train = torch.from_numpy(x_train).float()  #转换成float tensor

y_train = torch.from_numpy(y_sample).float().unsqueeze(1)  #转化成float tensor
定义需要优化的参数wi
#定义参数和模型
w = Variable(torch.randn(3,1),requires_grad=True)
b = Variable(torch.zeros(1),requires_grad=True)

#将x和y转换成Variable
x_train = Variable(x_train)
y_train = Variable(y_train)

def multi_linear(x):
    return torch.mm(x,w) + b
#画出之前的模型
y_pred = multi_linear(x_train)
plt.plot(x_train.data.numpy()[:,0],y_pred.data.numpy(),label='fitting curve',color='r')
plt.plot(x_train.data.numpy()[:,0],y_sample,label='real curve',color='b')
plt.legend()

#计算误差,和之前一样
loss = get_loss(y_pred,y_train)
print(loss)

#自动求导
loss.backward()

#查看一下w和b的梯度
print(w.grad)
print(b.grad)

#更新参数
w.data = w.data - 0.001 * w.grad.data
b.data = b.data - 0.001 * b.grad.data

#画出更新一次后的模型
y_pred = multi_linear(x_train)
plt.plot(x_train.data.numpy()[:,0],y_pred.data.numpy(),label='fitting curve',color='r')
plt.plot(x_train.data.numpy()[:,0],y_sample,label='real curve',color='b')
plt.legend()
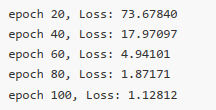
for e in range(100)    #进行100次更新
    y_pred = multi(x_train)
    loss = get _loss(y_pred,y_train)

    w.grad.data.zero_()
    b.grad.data.zero_()
    loss.backward()

    #更新参数
    w.data = w.data - 0.001 * w.grad.data  #更新w
    b.data = b.data - 0.001 * b.grad.data  #更新w
    if(e + 1) % 20 == 0:
        print('epoch{},loss:{:.5f}'.formate(e+1,loss.data[0]))
#画出更新之后的结果
y_pred = multi_linear(x_train)

plt.plot(x_train.data.numpy()[:,0],y_pred.data.numpy(),label='fitting curve',color='r')
plt.plot(x_train.data.numpy()[:,0],y_sample,label='real curve',color='b')
plt.legend()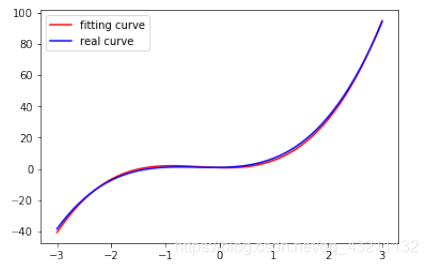
Logistic回归
Logistic回归和线性回归一样,唯一不同的地方在意Logistic回归会对y作用一个logistic函数,将其变为一种概率结果。Logistic函数也成为Sigmoid函数。
公式:
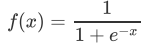
图像:
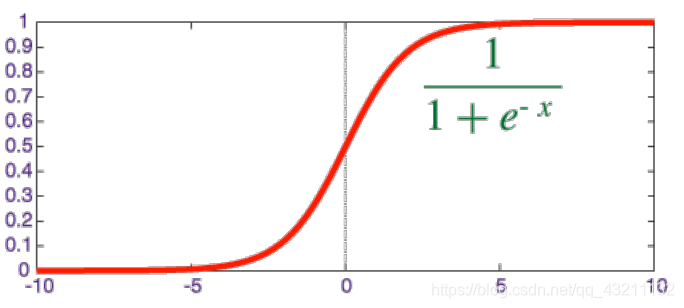
将值控制在0~1内。值越小就是第一类,越大就是第二类。
回归问题VS分类问题
分类问题希望把数据集分到某一类,是一个离散问题。
回归问题是一个连续问题,比如曲线的拟合,结果是一个连续的值。
分类问题和回复问题是机器学习和深度学习的第一步,拿到任何一个问题,都需要先确定其到底是分类还是回归,然后在进行算法设计。
损失函数
Logistic回归使用了Sigmoid函数将结果变成0~1之间,对于任意输入一个数据,经过Sigmoid之后结果记为y^,标书这个数据点属于第二类的概率,那么其属于第一类的概率就是1-y^。如果数据点属于第二类,就希望y^大,属于第二类就小,损失函数:
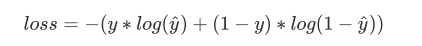
y表示真实的label,只能取{0,1}两个值,因为y^表示经过Logistic回归预测之后的结果,是一个0~1之间的小数。如果y是0,表示该数据属于第一类,此时希望y^越小越好,上面的loss函数变成:
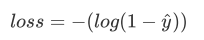
训练模型的时候希望最小化loss,根据loss函数的单调性,也就是最小化y^。
如果y是1,表示数据属于第二类。loss变成:
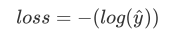
Pytorch实现
定义sigmoid函数
#定义sigmoid函数
def sigmoid(x):
    return 1/(1 + np.exp(-x))
或者直接调用:
import torch.nn.function as F
F.sigmoid()
定义Logistic回归模型
w = Variable(torch.randn(2,1),requires_grad=True)
b = Variable(torch.zeros(1),requires_grad=True)

def logistic_regression(x):
    return F.sigmoid(torch.mm(x,w) + b)
#定义二分类的loss函数 clamp是控制参数范围,大于括号里
def binary_loss(y_pred,y):
logits = (y * y_pred.clamp(1e-12).log() + (1 - y) * (1 - y_pred).clamp(1e-12).log()).mean()
return logits
y_pred = logistic_regression(x_data)
loss = binary_loss(y_pred,y_data)
#自动求导并更新参数
loss.backward()
w.data = w.data - 0.1 * w.grad.data
b.data = b.data - 0.1 * b.grad.data
简便的更新参数:
用 pytorch中带的优化器,Optimizer更新。
torch.optim#使用torch.optim更新参数
from torch import nn
w = nn.Parameter(torch.randn(2,1))
b = nn.Parameter(torch.zeros(1))
def logistic_regression(x):
return F.sigmoid(torch.mm(x,w) + b)
optimizer = torch.optim.SGD(w,b],lr=1.)
optimizer.zero_grad() #使用优化器将梯度归为0
loss.backward() #对参数求梯度
optimizer.step() #使用优化器来更新参数注:①Parameter和Variable一样,只是Parameter是Variable的一个子类,默认需要求梯度,能够自动注册到pytorch中的model中。
②SGD表示随机梯度下降。
#进行1000次更新
for e in range(1000):
    y_pred = logistic_regression(x_data)
    loss = binary_loss(y_pred,y_data)  #计算loss

    optimizer.zero_grad()  #使用优化器将梯度归为0
    loss.backward()  #对参数求梯度
    optimizer.step()  #使用优化器来更新参数
更多的loss
#使用自带的loss
criterion = nn.BCEWithLogitsLoss()  #将sigmoid和loss写在一层,有更快的速度,更好的稳定性
y_pred = logistic_reg(x_data)
loss = criterion(y_pred,y_data)
代码练习:
import torch
from torch.autograd import Variable
import numpy as np
import matplotlib.pyplot as plt
%matplotlib inline
#设定随机种子
torch.manual_seed(2017)
我们从data.txt读入数据
读入数据点后悔根据不同的label将数据点分为红色和蓝色,并画图展示出来。
#从data.txt中读入点
with open('./data.txt','r') as f:
    data_list = [i.split('\n)[0].split(',') for i in f.readlines()]
    data = [(float(i[0]),float(i[1]),float(i[2])) for i in data_list]

#标准化
x0_max = max([i[0] for i in data])
x1_max = max([i[1] for i in data])
data = [(i[0]/x0_max,i[1]/x1_max,i[2]) for i in data]

x0 = list(filter(lambda x:x[-1] == 0.0,data)) #选择第一类点
x1 = list(filter(lambda x:x[-1] == 1.0,data)) #选择第二类点

plot_x0 = [i[0] for i in x0]
plot_y0 = [i[1] for i in x0]
plot_x1 = [i[0] for i in x1]
plot_y1 = [i[1] for i in x1]

plt.plot(plot_x0,plot_yo,'ro',label='x_0')
plt.plot(plot_x1,plot_y1,'ro',label='x_1')
plt.legend(loc='best')注:split用法
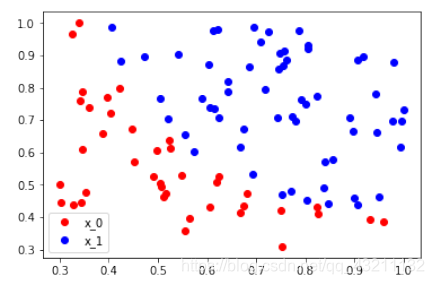
接下来将数据转换成Numpy的类型,接着转换到 Tensor为之后的训练做准备。
np_data = np.array(data,dtype='float') #转换成numpy array
x_data = torch.from_numpy(np_data[:,0:2]) #转换成Tensor,大小是[100,2]
y_data = torch.from_numpy(np_data[:,-1]).unsqueeze(1) #转换成Tensor,大小是[100,1]
接下来是sigmoid函数
#定义sigmoid函数
def sigmoid(x):
    return 1 / (1 +np.exp(-x))
画出Sigmoid函数,可以看到值越大,经过sigmoid函数之后越靠近1,值越小越靠近0.
#画出sigmoid的图像
plot_x = np.arange(-10,10.01,0.01)
plot_y = sigmoid(plot_x)

plt.plot(plot_x,plot_y,'r')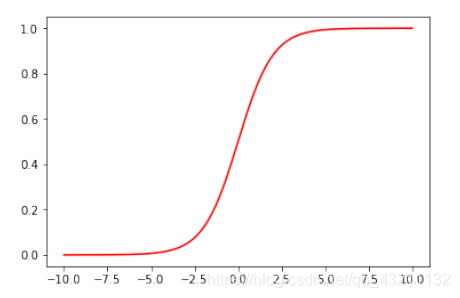
x_data = Variable(x_data)
y_data = Variable(y_data)
在pytorch中不需要自己写sigmoid函数,直接调用速度要比自己实现更快,稳定性更好,
通过导入torch.nn.functional来使用
import torch.nn.functional as F#定义logistic回归模型
w = Variable(torch.randn(2,1),requires_grad=True)
b = Variable(torch.zeros(1),requires_grad=True)
def logistic_regression(x):
return F.sigmoid(torch.mm(x,w) + b)在更新之前,可以画出分类的效果
#画出参数更新前的效果
w0 = w[0].data[0]
w1 = w[1].data[0]
b0 = b.data[0]

plot_x = np.arange(0.2,1,0.01)
plot_y = (-w0 * plot_x - b0) / w1

plt.plot(plot_x,plot_y,'g',label='cutting_line')
plt.plot(plot_x0,plot_y0,'ro',label='x_0')
plt.plot(plot_x1,plot_y1,'bo',label='x_1')
plt.legend(loc='best')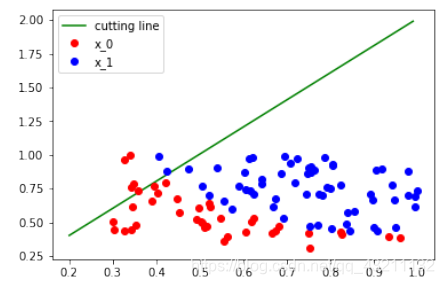
计算loss:
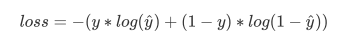
#计算loss
def binary_loss(y_pred,y):
    logits = (y * y_pred.clamp(1e-12).log() + (1 - y) * (1 - y_pred).clamp(1e-12).log()).mean()
    return -logits
y_pred = logistic_regression(x_data)
loss = binary_loss(y_pred,y_data)
print(loss)
得到loss之后,还是使用梯度下降法更新参数,这里可以用自动求导直接得到参数的导数;
#自动求导并更新参数
loss.backward()
w.data = w.data - 0.1 * w.grad.data
b.data = n.data - 0.1 * b.grad.data

#算出一次更新后的loss
y_pred = logistic_regression(x_data)
loss = binary_loss(y_pred,y_data)
print(loss)
注意:
①如果参数有100个就需要写100行来更新参数,过于繁琐,pytorch里面有封装好的函数来做此事,就是pytorch中的优化器,torch.optim
②使用torch.optim需要另外一个数据类型就是,nn.Parameter
③使用torch.optim.SGD可以使用梯度下降法来更新参数,PyTorch中的优化器有更多的优化算法。
④将参数w和b放到torch.optim.SGD中之后,说明一下学习率的大小,就可以使用optimizer.step()来更新参数了。
比如:
#使用torch.optim更新参数
from torch import nn
w = nn.Parameter(torch.randn(2,1))
b = nn.Parameter(torch.zeros(1))

def logistic_regression(x):
    return F.sigmoid(torch.mm(x,w) + b)

optimizer = torch.optim.SGD([w.b],lr=1.)
#进行1000次更新
import time

start = time.time()
for e in range(1000):
    #前向传播
    y_pred = logistic_regression(x_data)
    loss = binary_loss(y_pred,y_data) #计算loss
    #反向传播
    optimizer.zero_grad() #使用优化器将梯度归0
    loss.backward()
    optmizer.step() #使用优化器来更新参数
    #计算正确率
    mask = y_pred.ge(0.5).float()
    acc = (mask = y_data).sum().data[0] / y_data.shape[0]
    if(e + 1) % 200 == 0:
        print('epoch:{},Loss:{:.5f},Acc:{:.5f}'.format(e+1,loss.data[0],acc))
during = time.time() - start
print()
print('During Time:{:.3f}s'.format(during))
使用优化器之后更新参数非常简单,只需要在自动求导之前optimizer.zero_grad()来归来0梯度,然后使用optimizer.step()来跟新参数就可以了,非常简便。
画出更新之后的结果
#画出更新之后的结果
w0 = w[0].data[0]
w1 = w[1].data[0]
b0 = b.data[0]

plot_x = np.arange(0.2,1,0.01)
plot_y = (-w0 * plot_x - b0) / w1

plt.plot(plot_x,plot_y,'g',label='cutting_line')
plt.plot(plot_x0,plot_y0,'ro',label='x_0')
plt.plot(plot_x1,plot_y1,'bo',label='x_1')
plt.legend(loc='best')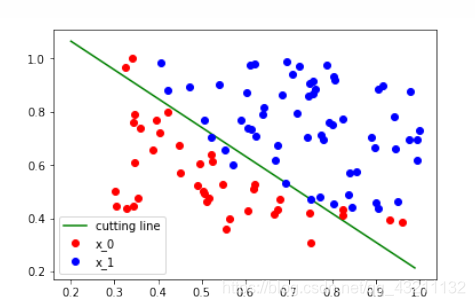
PyTorch也提供了一些loss,比如线性回归里面的loss是nn.MSE(),而Logistic回归的二分类loss在Pytorch中是nn.BCEWithLogitsLoss(),哈游很多
另外,PyTorch处于稳定性考虑,将模型的Sigmoid操作和最后的loss都合在了,nn.BCEWithLogitsLoss(),所以我们使用PyTorch自带的loss就不需要再加上Sigmoid操作了。
#使用自带的loss
criterion = nn.BEWithLogitsLoss()  #将sigmoid和loss写在一层,有更快的速度更好的稳定性
w = nn.Parameter(torch.rand(2,1))
b = nn.Parameter(torch.zeros(1))

def logistic_reg(x):
    return torch.mm(x,w) + b  #mm是矩阵相乘
optimizer = torch.optim.SGD([w.b],1.)y_pred = logistic_reg(x_data)
loss = criterion(y_pred,y_data)
print(loss.data)#进行1000次更新
import time
start = time.time()
for e in range(1000):
#前向传播
y_pred = logistic_regression(x_data)
loss = binary_loss(y_pred,y_data) #计算loss
#反向传播
optimizer.zero_grad() #使用优化器将梯度归0
loss.backward()
optmizer.step() #使用优化器来更新参数
#计算正确率
mask = y_pred.ge(0.5).float()
acc = (mask = y_data).sum().data[0] / y_data.shape[0]
if(e + 1) % 200 == 0:
print('epoch:{},Loss:{:.5f},Acc:{:.5f}'.format(e+1,loss.data[0],acc))
during = time.time() - start
print()
print('During Time:{:.3f}s'.format(during))多层神经网络
添加激活函数的原因:如果不添加激活函数就会使多层神经网络变成一层神经网络。
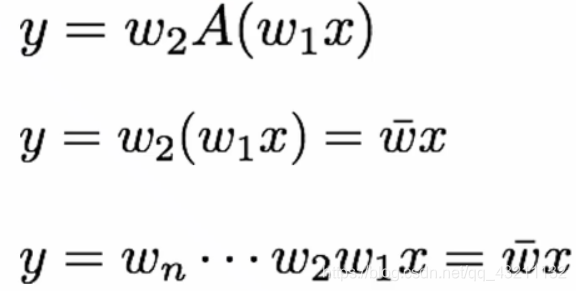
PyTorch实现
#定义两层神经网络的参数
w1 = nn.Parameter(torch.randn(2,4) * 0.01)  #隐藏层神经元个数2
b1 = nn.Parameter(torch.zeros(4))

w2 = nn.Parameter(torch.randn(4,1) * 0.01)
b2 = nn.Parameter(torch.zeros(1))

#定义模型
def two_network(x):
    x1 = torch.mm(x,w1) + b1
    x1 = F.tanh(x1)  #使用PyTorch自带的tanh激活函数
    x2 = torch.mm(x1,w2) + b2
    return x2
optimizer = torch.optim.SGD([w1,w2,b1,b2],1.)
criterion = nn.BCEWithLogitsLoss()

#训练10000次
for e in range(10000):
    out = two_network(Variable(x))
    loss = criterion(out,Variable(y))
    optimizer.zero_grad()
    loss.backward()
    optimier.step()
    if (e + 1) % 1000 == 0:
        print('epoch:{},loss:{}.format(e+1,loss.data[0]))
PyTorch的内置nn模块
nn模块中有很多函数,上面的两层网络无需手写的那么复杂,可以用更简单的方式定义:
#nn.Sequential可以定义序列化的模型,例如上面的3层网络,可以按照顺序进行定义
seq_net = nn.Sequential(
    nn.Linear(2,4), #PyTorch中的线性层,wx+b  输入是2维向量,输出是4维向量
    nn.Tanh(),
    nn.Linear(4,1)
)
除了简单的序列化网络构建方式Sequential之外,PyTorch提供了一种更加灵活的网络定义方式,叫做nn.Module
#Module模板
class 网络名字(nn.Module):
    def_init_(self,一些定义的参数):
        super(网络名字,self)._init_()
        self.layer1=
nn.Linear(num_input,num_hidden)
    self.layer2 = nn.Sequential(...)


#定义需要的网络层
def forward(self,x): #定义前向传播
    x1 = self.layer1(x)
    x2 = self.layer2(x)
    x = x1 + x2
    ...
    return x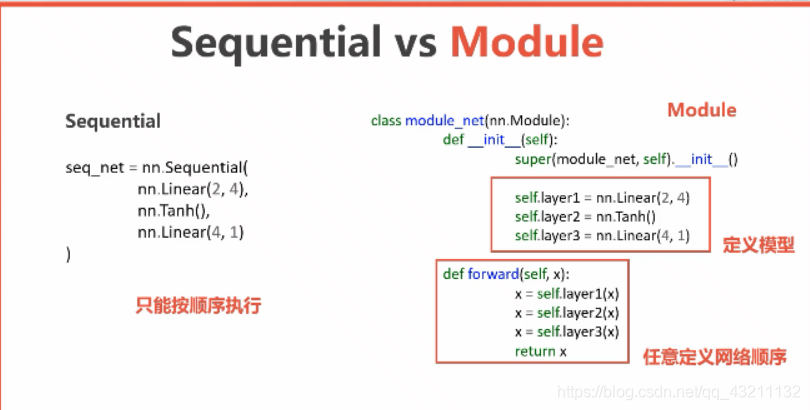
使用第二种方式的原因:更加灵活,因为在forward里面可以定义任何你想要的的操作。层之间可以灵活调用。
#Sequential 序列模块可以通过索引访问每一层
seq_net[0] #第一层

Linear(in_features=2,out_features=4)
#打印第一层的权重
w0 = seq_net[0].weight
print(w0)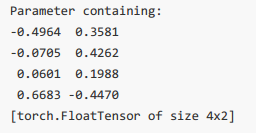
@通过parameter可以取得模型参数
param = seq_net.parameter()

#定义优化器
optim = torch.optim.SGD(param,1.)
#训练10000次
for e in range(10000):
out = seq_net(Variable(x))
loss = criterion(out,Variable(y))
optimizer.zero_grad()
loss.backward()
optimizer.step()
if (e + 1) % 1000 == 0:
print('epoch:{},loss:{}'.format(e+1,loss.data[0]))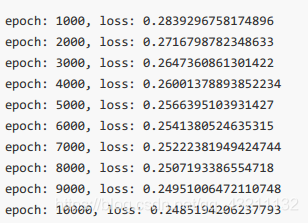
训练10000次loss比之前的更低了,是因为PyTorch自带的米快比我们写的更加稳定
def plot_seq(x):
    out = F.sigmoid(seq_net(Variable(torch.from_numpy(x).float()))).data.numpy()
    out = (out > 0.5) * 1
    return out
plot_decision_bounary(lamnda x:plot_seq(x),x.numpy(),y.numpy())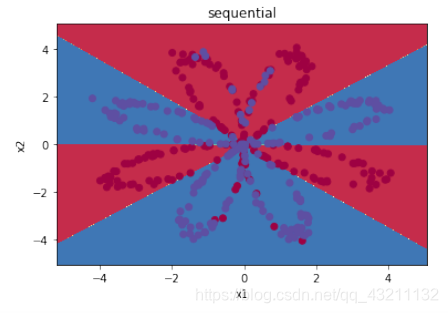
多层神经网络,Sequential和Module代码练习
import torch
import numpy as np
from torch import nn
from torch.autograd import Variable
import torch.nn.functional as F

import matplotlib.pyplot as plt
%matplotlib inline
def plot_decision_boundary(model,x,y):
#Set min and max values and give it some padding
x_min, x_max = x[:,0].min() - 1,x[:,0].max() + 1
y_min, y_max = y[:,1].min() - 1,y[:,1].max() + 1
h = 0.01
#generater a gridof points with distance h between them
xx, yy = np.meshgrid(np.arange(x_min,x_max,h),np.arange(y_min,y_max,h))
#Predic the funcion value for the whole grid
Z = model(np.c_[xx.ravel(),yy.ravel()])
Z = Z.reshape(xx.shape)
#Plot the counter and training wxamples
##plt.cm.Spectral,在这的意思就是颜色会随Z的值变化
plt.contourf(xx,yy,Z,cmap=plt.cm.Spectral)
plt.ylabel('x2')
plt.xlabel('x1')
plt.scatter(x[:,0],x[:,1],c=y.reshape(-1),s=40,cmap=plt.cm.Spectral)注意:meshgrid作用,ravel()作用,contourf作用,scater作用
这次仍然使用一个二分类问题,但是比前面的logistics回归更复杂
np.random.seed(1)
m = 400 #样本数量
N = int(m/2) #每一类的点的个数
D = 2 #维度
x = np.zeros((m,D))
y = np.zeros((m,1),dtype='uint8')  #label向量,0表示红色,1表示蓝色
a = 4
for j in range(2):
    ix = range(N*j,N*(j+1))
    t = np.linspace(j*3.12,(j+1)*3.12,N) + np.random.randn(N)*0.2 #theta
    x[ix] = np.c_[r*np.sin(t),r*np.cos(t)]
    y[ix] = j
plt.scatter(x[:,0],x[:,1],c=y.reshape(-1),s=40,cmap=plt.cm.Spectral)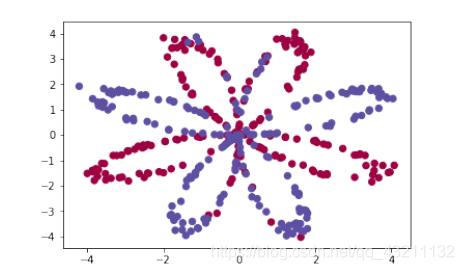
可以尝试用logistic回归来解决这个问题
x = torch.from_numpy(x).float()
y = torch.from_numpy(y).flaot()
w = nn.Parameter(torch.randn(2,1))
b = nn.Parameter(torch.zeros(1))

optimizer = torch.optm.SGD([w.b],1e-1)

def logistic_regrssion(x):
    return torch.mm(x,w) + b

criterion = nn.BCEWithLogitsLoss()

for e in range(100):
    out = logistic_regrssion(Variable(x))
    loss = criterion(out,Variable(y))
    loss.backward()
    optimizer.step()
    if(e + 1) % 20 == 0:
        print('epoch:{},loss:{}'.format(e+1,loss.data[0]))

def plot_logistic(x):
    x = Variable(torch.from_numpy(x).float())
    out = F.sigmoid(logistic_regression(x))
    out = (out > 0.5) * 1
    return out.data.numpy()
   plot_decision_boundary(lambda x:plot_logistic(x),x.numpy(),y.numpy())
plt.title('logistic regression')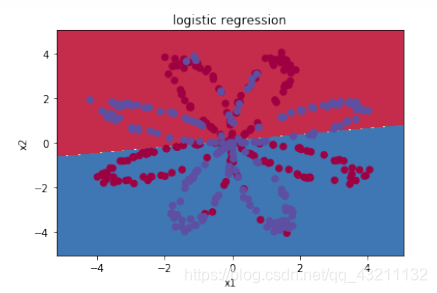
可以看到logistic回归并不能很好的区分开这个复杂的数据集,因为它是一个线性分类器,这个时候就需要神经网络了
#定义两层神经网络的参数
w1 = nn.Parameter(torch.randn(2,4) * 0.01) #隐藏层神经元个数2
b1 = nnParameter(torch.zeros(4))

w2 = nn.parameter(torch.randn(4,1) * 0.01)
b2 = nn.Parameter(torch.zeros(1))

#定义模型
def two_network(x):
    x1 = torch.mm(x,w1) + b1
    x1 = F.tanh(x1)  #自带
    x2 = torch.mm(x1,w2) + b2
    return x2
optimizer = torch.optim.SGD([w1,w2,b1,b2],1.)
criterion = nn.BCEWithLogitsLoss()
#训练1000次
for e in range(1000):
    out = two_network(Variable(x))
    loss = criterion(out,Variable(y))
    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
    if (e + 1) % 1000 == 0:
        print('epoch:{},loss:{}'.format(e+1,loss.data[0]))
def plot_network(x):
x = Variable(torch.from_numpy(x).float())
x1 = torch.mm(x,w1) + b1
x1 = F,tanh(x1)
x2 = torch.mm(x1,w2) +b2
out = F.sigmoid(x2)
out = (out > 0.5) * 1
return out.data.numpy()plot_decision_boundary(lambda x:plot_network(x),x.numpy(),y.numpy())
plt.title('2 layer network')Text(0.5,1,'2 layer network')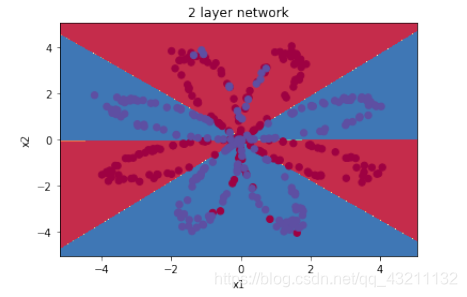
保存模型
保存模型在PyTorch中有两种方式,一种是将模型结构和参数都保存在一起,一种是只将参数保存下来。
#将参数和模型保存在一起
torch.save(seq_net,'save_seq_net.pth')
torch.save里面的两个参数,第一个是要保存的模型,第二个是保存的路径
#读取保存的模型
seq_net1 = torch.load('save_seq_net.pth')

print(seq_net1[0].weight)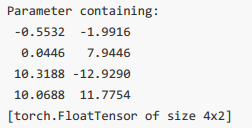
我们看到我们重新输入了模型,并且将其命名为seq_net1,并且打印了第一层的参数
下面看看第二种保存模型的方式,只保存参数而不保存模型结构
#保存模型参数
torch.save(seq_net.state_dict(),'save_seq_net_params.pth')
通过上面的方式,我们保存了模型的参数,如果要重新读入模型的参数,首先需要重新定义一次模型,接着重新读入新参数。
seq_net2 = nn.Sequential(
    nn.Linear(2,4),
    nn.Tanh(),
    nn.Linear(4,1)
)
seq_net2.load_state_dict(torh.load('save_seq_net_params.pth'))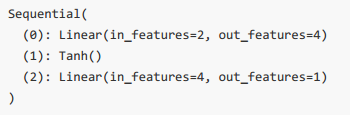
print(seq_net2[0].weight)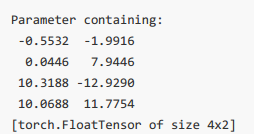
通过这种方式我们也重新读入了相同的模型,打印第一层的参数对比,发现和前面的办法是一样有这两种保存和读取模型的方法,推荐使用第二种,因为第二种可移植性更强。
class 网络名字(nn.Module):
    def _init_(self,一些定义的参数):
        super(网络名字,self)._init_()
        self.layer1 = nn.Linear(num_input,num_hidden)
        self.layer2 = nn.Sequential(...)
        ...
        定义需要的网络层
    def forward(self,x):   #定义前向传播
        x1 = self.layer1(x)
        x2 = self.layer2(x)
        x = x1 + x2
        ...
        return x
注意:Module里面可以使用Sequential,同时Module非常灵活,具体体现在forward中。
下面照着模板实现一下上面的神经网络
class module_net(nn.Module):
    def _init_(self,num_input,num_hidden,num_output):
        super(module_net,self)._init_()
        self.layer1 = nn.Linear(num_input,num_hidden)

        slef.layer2 = nn.Tanh()

        self.layer3 = nn.Linear(num_hidden,num_output)
    delf forward(self,x):
        x = self.layer1(x)
        x = self.layer2(x)
        x = self.layer3(x)
        return x
no_net = nodule_net(2,4,1)#访问模型中的某曾可以直接通过名字
#第一层
l1 - mo_net.layer1
print(l1)
Linear(in_features=2,out_features=4)#打印出第一层的权重
print(l1.weight)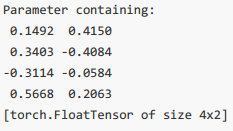
#定义优化器
optim = torch.optim.SGD(mo_net.parameters(),1.)
3我们训练10000次
for e in range(10000):
out = mo_net(Variable(x))
loss = criterion(out,Variable(y))
optim.zero_grad()
loss.backward()
optim.step()
if (e + 1) % 1000 == 0:
print('epoch:{},loss:{}'.format(e+1,loss.data[0]))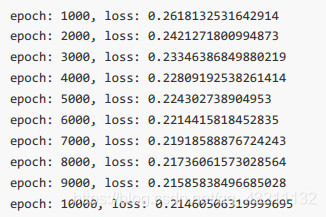
#保存模型
torch.save(mo_net.state_dict(),'module_net.pth')
反向传播算法
复杂模型步骤:
1、正向求节点值
2、反向传播求梯度
3、用梯度更新节点值
4、重新回到1
优化算法:
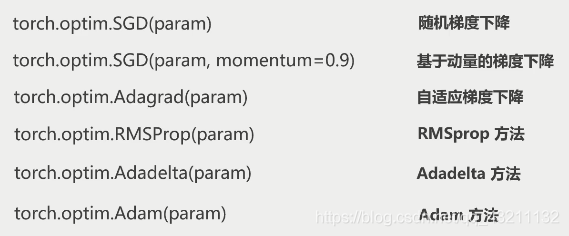
自动求导的本质就是一个反向传播。
参数初始化
使用numpy来初始化
因为PyTorch是一个非常灵活的框架,理论上能够对所有的Tensor进行操作,所以能够通过定义新的Tensor来初始化,下面就是个例子:
import numpy as np
import torch
from torch import nn
#定义一个Sequential模型
net1 = nn.Sequential(
nn.Linear(30,40),
nn.Relu(),
nn.Linear(40,50),
nn.Relu(),
nn.Linear(50,10)
)#访问第一层的参数
w1 = net1[0].weight
b1 = net1[0].bias
print(w1)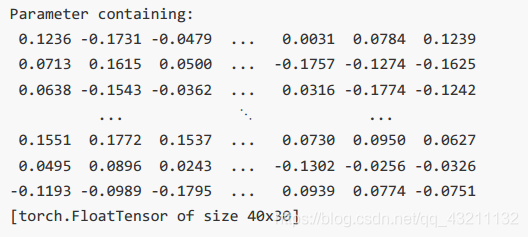
注意,这是一个Parameter,也就是一个特殊的Variable,我们可以访问其.data属性得到其中的数据,然后直接定义一个新的Tensor对其进行替换,我们可以使用Pytorch中的一些随机数据生成的方式,比如torch.randn,如果要使用更多Pytorch中没有随机化方式,可以使用numpy。
#定义一个Tensor直接对其进行替换
net1[0].weight.data = torch.from_numpy(np.random.uniform(3,5,size=(40,30)))

print(net1[0].weight)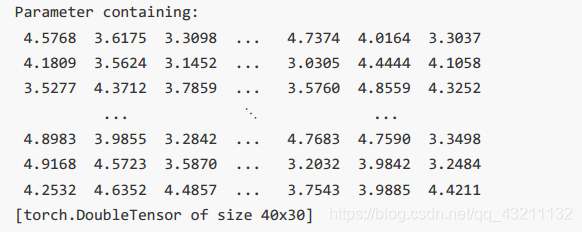
可以看到这个参数的值已经被改变了,也就是说已经被定义成了我们需要的初始化方式,如果模型中某一层需要我们手动去修改,那么我们可以直接用这种方式去访问,但是更多的时候模型中相同类型的层都需要初始化成相同的方式,这个时候一种更高效的方式是使用循环去访问,比如:
for layer in net1:
    if isinstance(layer,nn.Linear):#判断是否是线性层
        param_shape = layer.weight.shape
        layer.weight.data = torch.from_numpy(np.random.normal(0,0.5,size=param_shape)) #定义均值为0,方差为0.5的正态分布
给出以下初始化方式:
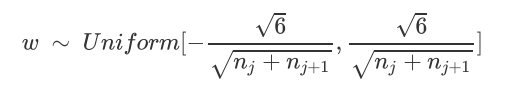
其中nj和nj+1表示改成的输入和输出数目,所以请尝试实现以下初始化方式。
对于Module的参数初始化,其实非常简单,如果想对其中的某层进行初始化,可以字节像Sequential一样对其Tendor进行重新定义,唯一不同的地方在于,若果要用循环的方式访问,需要介绍两个属性,Children和modules,例如:
class sim_net(nn.Modlule):
    def _init_(self):
        super(sim_net,self)._init_()
        self.l1 = nn.Sequential(
        nn.Linear(30,40),
        nn.ReLU()
    )
        self.l1[0].weight.data = torch.randn(40,30)#直接对某一层初始化
        self.l2 = nn.Sequential(
            nn.Linear(40,50),
            nn.ReLU()
    )
        self.l3 = nn.Sequential(
            nn.Linear(50,10),
            nn.ReLU()
    )
    def forward(self,x):
        x = self.l1(x)
        x = self.l2(x)
        x = self.l3(x)
        return x
net2 = sim_net()
#访问children
for i in net2.Children():
    print(i)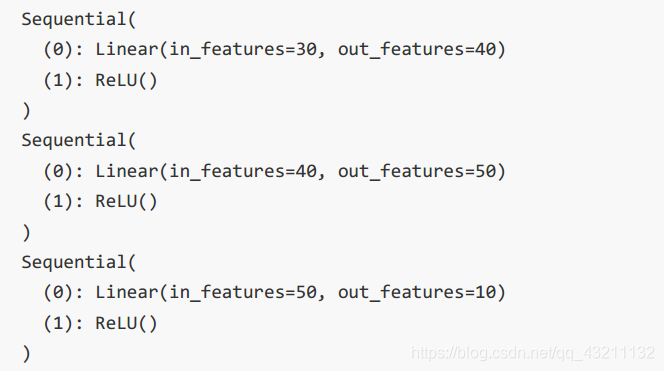
#范文modules
for i in net2.modules():
    print(i)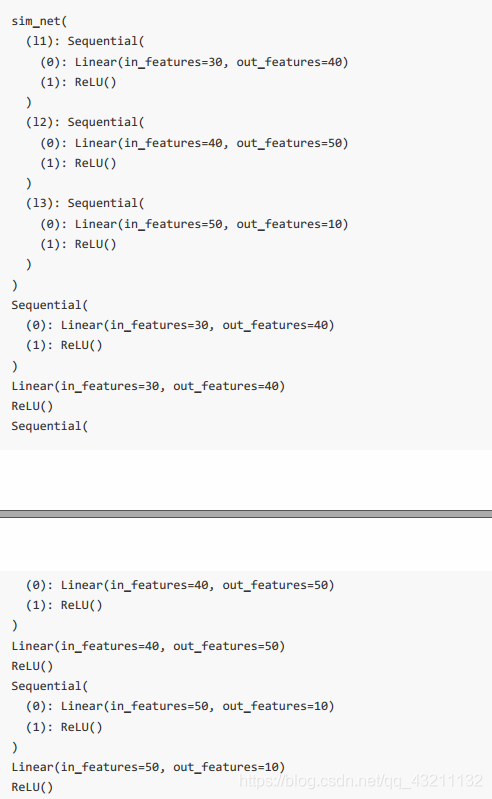
上面的例子区别:
children只会访问到模型定义的第一层,因为上面的模型中定义了3个Sequential,所以只会访问到3个Sequential,而modules会访问到最后的结构,比如上面的例子,modules不仅仅访问到了Sequential,也访问到了Sequential里面,这样对我们做初始化非常方便,比如
for layer in net2.modules():
    if ininstance(layer,nn.Linear):
        param_shape = layer.weight.shape
        layer.weight.data = torch.from_numpy(np.random.mormal(0,0.5,size=param_shape))
这就实现了和Sequrntial相同的初始化,同样非常方便。
torch.nn.init
from torch.nn import init
print(net1[0].weight)
init.xavier_unitorm(net1[0].weight)#这就是Xavier初始化方法,PyTorch直接内置了其实现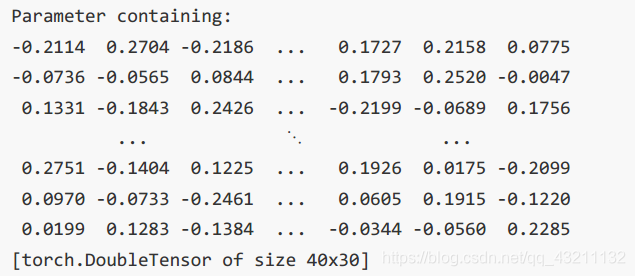
print(net1[0].weight)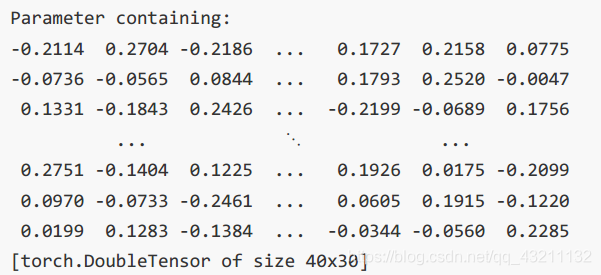
可以看到参数已经被修改了
torch.nn.init为我们提供了更多的内置的初始化方式,避免了我们重复去 实现一些相同的操作。
上面讲了两种初始化方式,其实它们的本质是一样的,就是去修改某一层参数的实际值,而torch.nn.init提供了更多成熟的深度学习相关的初始化方式,非常方便。
更多推荐


 3
 0
- 0


 已为社区贡献6条内容

所有评论(0)