
模式匹配算法----KMP算法以及next数组的解法
KMP算法:求字符串匹配(也叫模式匹配)的算法,即给定一个字符串,求其某一子串在其中出现的位置。
普通模式匹配
例如:给定字符串为abcabaaabaabcac,求其子串abaabcac在其中出现的位置。
结果为7
对于这种问题,没有经验的编程者通常会采用逐个匹配的方法,来得出结果。这就是最简单一种算法思想。
1. 逐个进行比较,如果相同,就继续比较下一个,但是我们可以看到下图中,c与a不相同,这就是所谓的“失配”。
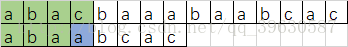
2. 当发生失配,我们会将子字符串逐个后移,直到新的匹配建立,再逐个比较
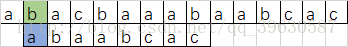
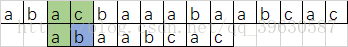
3.
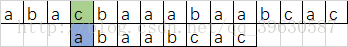
4.
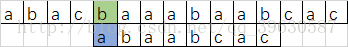
5.
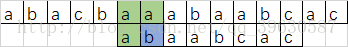
6.
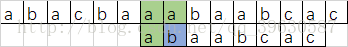
7.
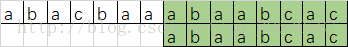
根据上面的方法,我们可以看到第二步有两个图,这是为什么呢?这是因为当出现失配时候,字符串每次后移一个的方法,不能够立刻建立匹配,还需要继续后移才能建立。也就是说,这种情况下,后移两个才能建立匹配。
当然这个例子比较小,只出现了两次这种情况,但是如果是较大的数据,这种冗余操作是十分低效的。这也就是KMP算法优化的地方。
KMP算法--next[]
KMP算法会创建一个next[]数组,用来保存一个字符失配后,到底跳转到第几个的位置才能更快速的建立匹配。这里用了跳转这个词,因为并不是向后移动next[i]位,而应该是直接跳转到相应的位置,使失配位与第next[i]位相对。这个数组是KMP算法的核心。
下面以字符串abaabcac为例,求解next数组,模式匹配的数组下标从1开始(这个算法推荐这么做,很多事情没有那么多理由)
next数组按照最长相等前后缀长度求解:
next[1],字符串“a”,前缀{},后缀{},没有相等前后缀,next记为0。要注意,前后缀均不包括整个串。
next[2],字符串“ab”,前缀{a},后缀{b},没有相等前后缀,next记为0。
next[3],字符串“aba”,前缀{a,ab},后缀{a,ba},相等前后缀{a},长度为1,next记为1。
next[4],字符串“abaa”,前缀{a,ab,aba},后缀{a,aa,baa},相等前后缀{a},长度为1,next记为1。
next[5],字符串“abaab”,前缀{a,ab,aba,abaa},后缀{b,ab,aab,baab},相等前后缀{ab},长度为2,next记为2。
next[6],字符串“abaabc”,前缀{a,ab,aba,abaa,abaab},后缀{c,bc,abc,aabc,baabc},相等前后缀{},next记为0。
next[7],字符串“abaabca”,前缀{a,ab,aba,abaa,abaab,abaabc},后缀{a,ca,bca,abca,aabca,baabca},相等前后缀{a},长度为1,next记为1。
next[8],字符串“abaabcac”,前缀{a,ab,aba,abaa,abaab,abaabc,abaabca},后缀{c,ac,cac,bcac,abcac,aabcac,baabcac},相等前后缀{},next记为0。
| i | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
| str.charAt(i) | a | b | a | a | b | c | a | c |
| next[i] | 0 | 0 | 1 | 1 | 2 | 0 | 1 | 0 |
由于使用next[]时,每次失配,都需要找它前面一个元素的next[]进行移动,为了方便,我们将next数组右移一位。最左侧填充-1,舍弃最右侧的元素。
| i | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
| str.charAt(i) | a | b | a | a | b | c | a | c |
| next[i] | -1 | 0 | 0 | 1 | 1 | 2 | 0 | 1 |
为了简化计算,我们对next[]整体+1,这里得到的是我们通常使用的next[]。
| i | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
| str.charAt(i) | a | b | a | a | b | c | a | c |
| next[i] | 0 | 1 | 1 | 2 | 2 | 3 | 1 | 2 |
求解next数组代码:
    private static int[] get_Next(String str){
        int[] next = new int[str.length()+1];
        int j = next[2];
        // 这里next[1]和next[2]直接赋值
        next[1] = 0;
        next[2] = 1;
        for(int i = 2; i < str.length(); i++) {
            while(j > 0 && str.charAt(i-1) != str.charAt(j)) {
            	j = next[j];
            }
            if(str.charAt(i-1) == str.charAt(j)) {
            	j++;
            }
            next[i] = j;
        }
        return next;
    }
KMP算法改进--nextval[]
比较当前next[i]的值,与
1.前两位必为0,1
计算nextval[3]时,我们可以知道第三位字符位‘a’,next[3]=1,故查看第1位的字符为‘a’,字符相同,所以nextval[3]=next[1]=0
计算nextval[4]时,我们可以知道第四位字符位‘a’,next[4]=2,故查看第2位的字符为‘b’,字符不同,所以nextval[4]=next[4]=2
计算nextval[5]时,我们可以知道第五位字符位‘b’,next[5]=2,故查看第2位的字符为‘b’,字符相同,我们知道next[2]=1,故继续查看第1位的字符为‘a’,字符不同,所以nextval[5]=next[2]=1
计算nextval[6]时,我们可以知道第六位字符位‘c’,next[6]=3,故查看第3位的字符为‘a’,字符不同,所以nextval[6]=next[6]=3
计算nextval[7]时,我们可以知道第七位字符位‘a’,next[7]=1,故查看第1位的字符为‘a’,字符相同,所以nextval[7]=next[1]=0
计算nextval[8]时,我们可以知道第八位字符位‘c’,next[8]=2,故查看第2位的字符为‘b’,字符不同,所以nextval[7]=next[7]=2
| i | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
| str.charAt(i) | a | b | a | a | b | c | a | c |
| nextval[i] | 0 | 1 | 0 | 2 | 1 | 3 | 0 | 2 |
根据next数组,我们再来做一遍这个题目:给定字符串为abcabaaabaabcac,求其子串abaabcac在其中出现的位置。
1.创建匹配,第4个字符发生失配
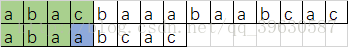
2.使失配位与子串的第next[4]=2位相对,但是这是第二个字符又失配了
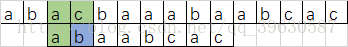
3.使失配位与子串的第next[2]=1位相对,此时第一个字符就失配
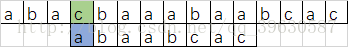
4.使失配位与子串的第next[1]=0位相对,注意我们的next数组是从1开始算的,所以相当于整体后移一个单位,下图的失配位实际是"c"
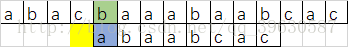
5.使失配位与子串的第next[4]=2位相对
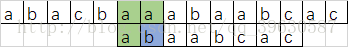
6.使失配位与子串的第next[4]=2位相对
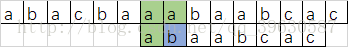
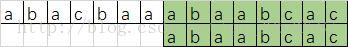
7.匹配成功
完整代码如下:
public class Main {
    public static void main(String[] args) {
    	String str = "abaabcac";
        String orig ="aabaabcac";
        int[] next = get_Next(str);
        for (int i = 1; i < next.length; i++) {
			System.out.print(next[i] + " ");
		}
        System.out.println();
        search(orig, str, next);
    }

    //next[i]表示的是str的"部分匹配表",这个表表示的是str前缀与后缀的最长公共字符串的长度
    private static int[] get_Next(String str){
        int[] next = new int[str.length()+1];
        int j = next[2];
        // 这里next[1]和next[2]直接赋值
        next[1] = 0;
        next[2] = 1;
        // 第2位之后的next,为什么从2开始,不是已经赋值了吗?这在于str.charAt(0)为字符串的第一个字母
        for(int i = 2; i < str.length(); i++) {
            while(j > 0 && str.charAt(i-1) != str.charAt(j)) {
            	j = next[j];
            }
            if(str.charAt(i-1) == str.charAt(j)) {
            	j++;
            }
            next[i] = j;
        }
        return next;
    }

    //orig为主串,而find为模式串,查找匹配位置以及匹配长度
    private static void search(String orig, String find, int[]next){
        int j = next[0];
        for(int i = 0;i < orig.length(); i++){
            while(j > 0 && orig.charAt(i) != find.charAt(j))
                j = next[j];
            if(orig.charAt(i) == find.charAt(j)){
                j++;
            }
            if(j == find.length()){
                System.out.println("find at position " + (i - j+1));
                System.out.println(orig.subSequence(i - j + 1, i + 1));
                j = next[j];
            }
        }
    }
}当然还有一种BM算法效率比KMP算法还好。有兴趣的读者可以参考时空权衡在模式匹配算法中的应用(JAVA)--Horspool算法(简化版BM算法)
nextval数组实际的数值是明显要小于next数组的,nextval数组由于考虑到了移动到的位置的数与当前位置数的关系,可以减少移动的距离。
更多推荐
 8
 0
- 0


 已为社区贡献3条内容

所有评论(0)