
在windows上使用vLLM部署Qwen2.5-VL-3B-Instruct-AWQ
·
环境Windows,
python版本: 3.10.12(vLLM支持python版本3.9 – 3.12)
windows下安装 vllm 的是要借用 WLS2,使用root账户安装
参考: https://blog.csdn.net/weixin_44301630/article/details/122390018
首先要在windows上安装显卡驱动,
nvidia-smi (windows和 wsl 都可以用)
1.创建虚拟环境,可以避免各种包版本冲突
创建虚拟环境:
python -m venv qwen-vl-env

激活虚拟环境:
source /opt/vllm/qwen-vl-env/bin/activate
激活后 前面会出现一个括号
 3. 安装CUDA
vLLM是针对linux优化的,且依赖 CUDA 工具链,需要安装CUDA
安装 PyTorch(带 CUDA 支持)
需要注意版本:
① 在设备管理器中查看显示器适配器,查看显卡型号

②访问CUDA GPU 支持列表
看一下CUDA是否支持CUDA
③ 安装CUDA Toolkit
访问 CUDA Toolkit Archive
选择正确的版本,下载安装
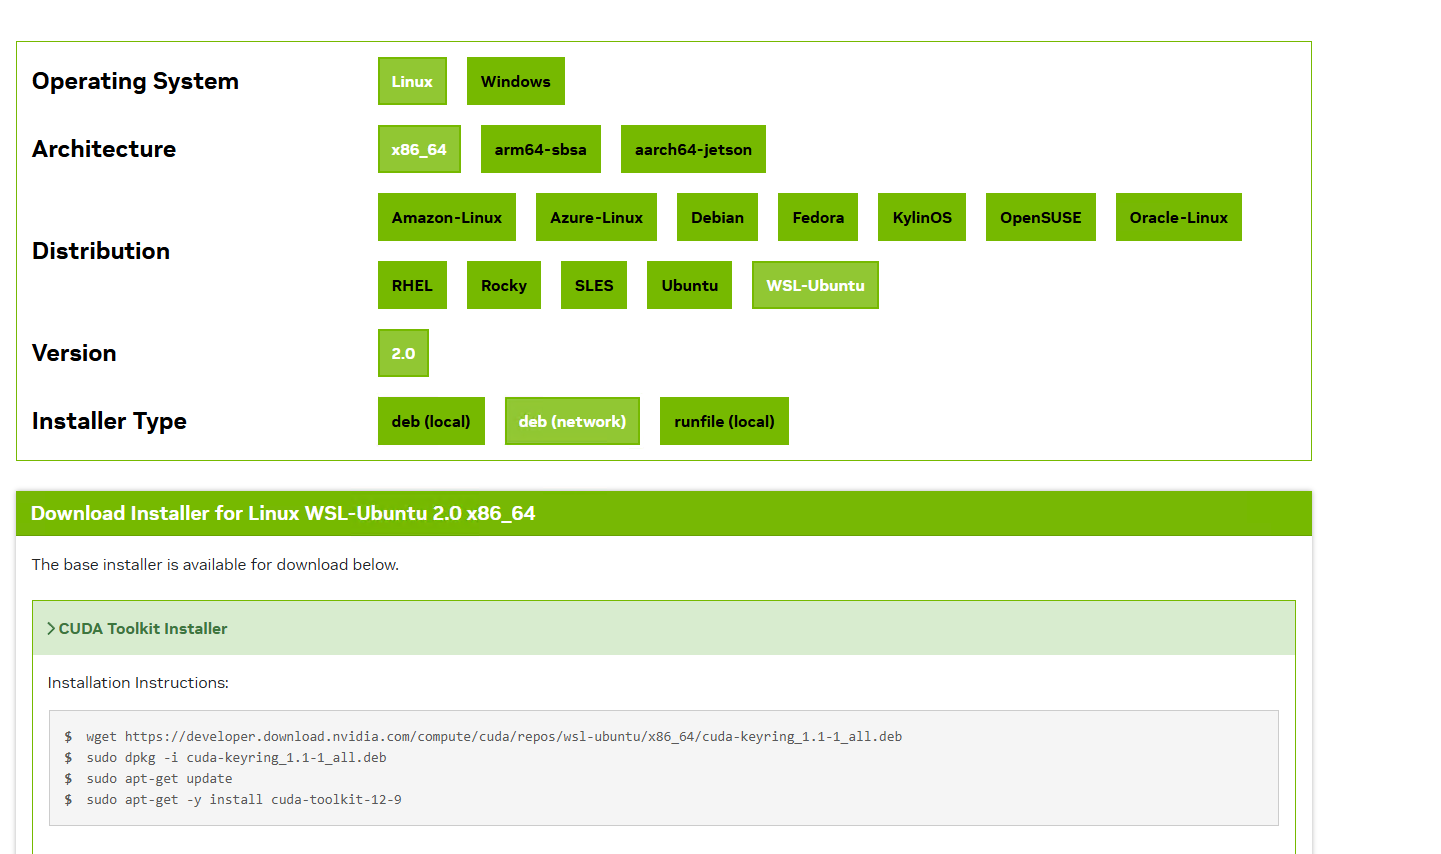
安装成功后查看CUDA 版本,不同的环境查看CUDA版本不同,
- 下载PyTorch
注意CUDA版本和PyTorch版本要兼容 根据你安装cuda版本来选,
从 PyTorch 官网 获取
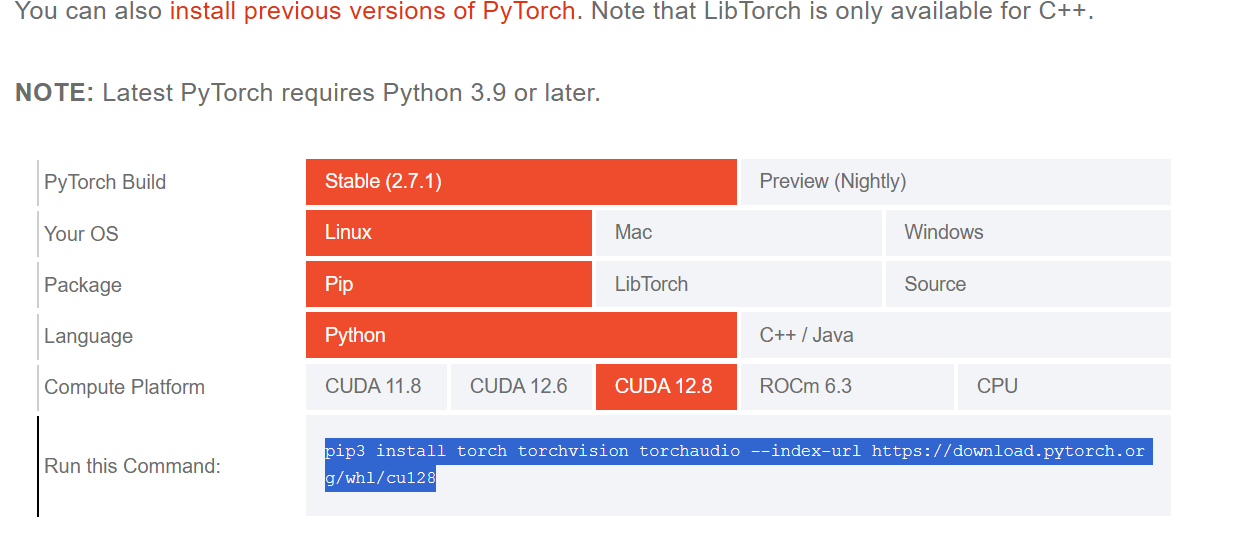
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu118
等待安装完成
说明: 红框中只是CUDA支持的的最高版本
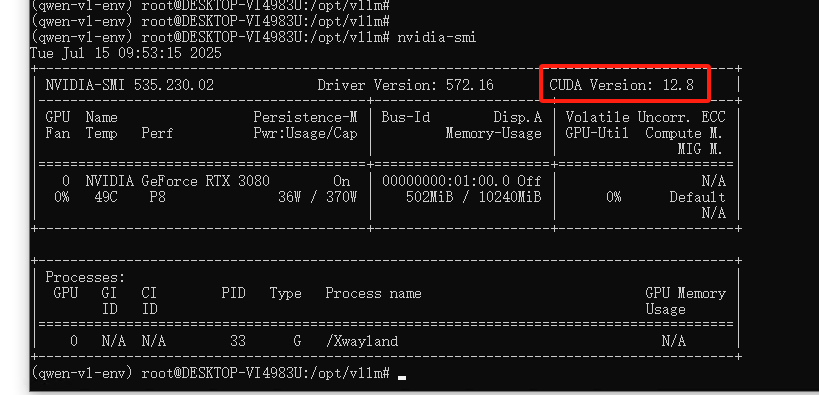
这个才是cuda当前版本
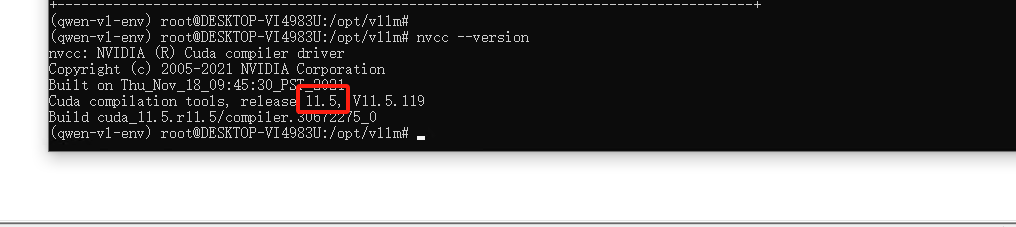
所以是cu118
验证安装
import torch
print(torch.__version__)        # 输出: 2.0.1+cu118
print(torch.version.cuda)       # 输出: 11.8
print(torch.cuda.is_available()) # 输出: True(若GPU可用)
- 安装vLLM
先将pip升级到到最新版本
pip install --upgrade pip
之后再安装vllm
pip install vllm
- 下载大模型
去魔搭社区找一个大模型 然后下载
modelscope download --model Qwen/Qwen2.5-VL-3B-Instruct-AWQ --local_dir ./models/Qwen2.5-VL-3B-Instruct-AWQ
启动:
  vllm serve /opt/vllm/models/Qwen2.5-VL-3B-Instruct-AWQ \
  --max-model-len 8192  \
  --gpu-memory-utilization 0.80  \
  --host 0.0.0.0  \
  --port 8081  \
  --served-model-name Qwen2.5-VL-3B-Instruct-AWQ

- 基本使用
curl http://10.0.0.54:8081/v1/chat/completions -H "Content-Type: application/json" -d '{"model": "Qwen2.5-VL-3B-Instruct-AWQ","messages": [{"role": "system", "conten": "You are a helpful assistant."},{"role": "user", "content": [{"type": "image_url", "image_url": {"url": "https://modelscope.oss-cn-beijing.aliyuncs.com/resource/qwen.png"}},{"type": "text", "text": "What is the text in the illustrate?"}]}]}
使用postman调用
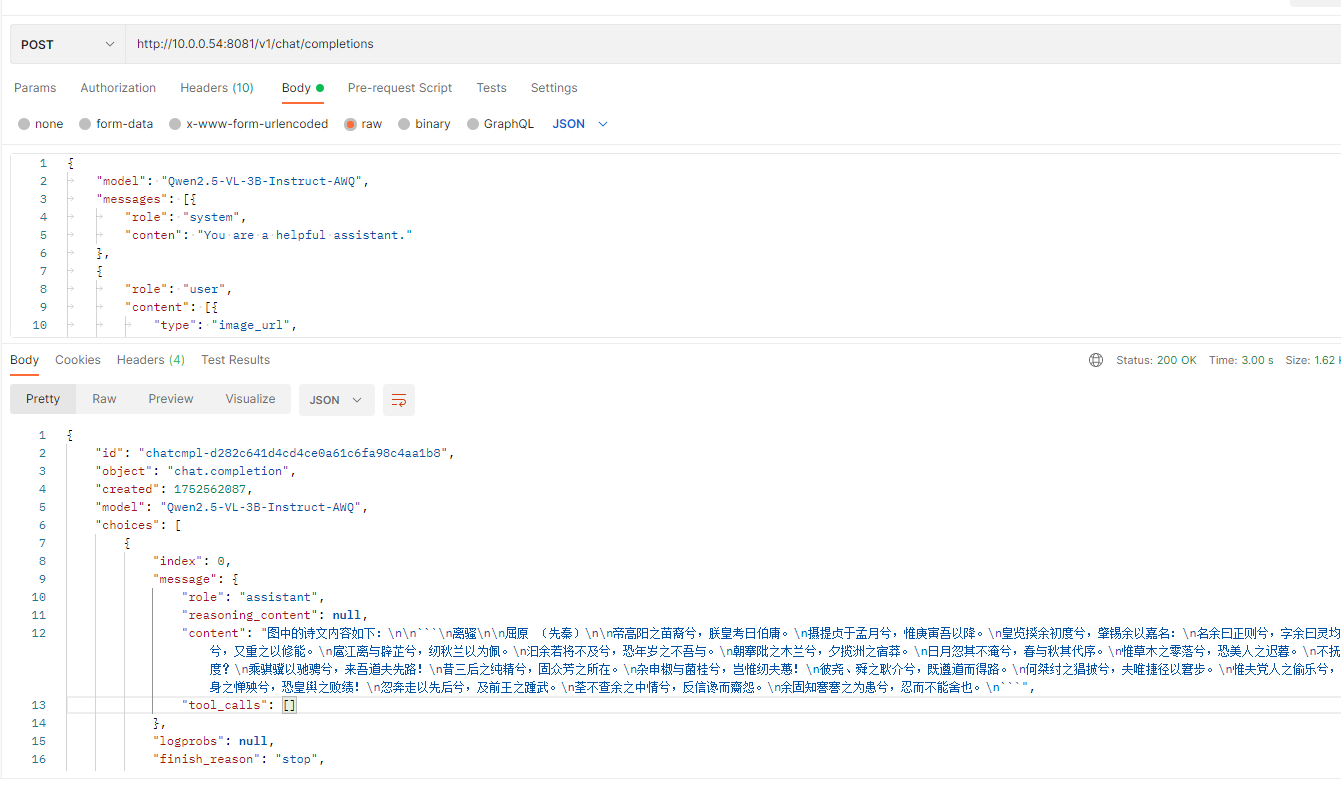
url: http://10.0.0.54:8081/v1/chat/completions
headers: Content-Type: application/json
body: {
	"model": "Qwen2.5-VL-3B-Instruct-AWQ",
	"messages": [{
		"role": "system",
		"conten": "You are a helpful assistant."
	},
	{
		"role": "user",
		"content": [{
			"type": "image_url",
			"image_url": {
				"url": "https://pic3.zhimg.com/v2-ea1e010d1d58208148849986a3ddcf56_r.jpg"
			}
		},
		{
			"type": "text",
			"text": "图中诗文的内容有哪些"
		}]
	}]
}
中间多有坎坷,各种缺包,各种报错, 报错丢到大模型(豆包/deepseek),通常都能出结果,注意版本兼容
整体流程就是:
- 安装wsl, 设置成wsl2
- 安装ubuntu
- 安装显卡驱动(windows上安装,注意版本)
- 安装python(vLLM支持python版本3.9 – 3.12)
- 安装虚拟环境(可选)
- 安装CUDA(注意版本兼容)
- 安装PyTorch(注意版本兼容)
- 安装vLLM
- 下载模型(注意模型所需显存,大了运行不起来)
- 使用 vllm serve启动模型(注意参数)
- 端口开放(wsl端口开放到windows上,然后映射到宿主机上,最后外面才能访问)
更多推荐

 24
 0
- 0


 已为社区贡献4条内容

所有评论(0)