
linux之调度管理(12)- SMP 负载均衡
一、进程负载均衡之PELT算法
PELT是内核中计算调度负载的一种算法,具体算法实现,在这里不讲,因为涉及了很多计算公式。我们只需要知道,在内核的 struct sched_avg 结构体中的数据,都是调用内核PELT算法函数接口。
PELT 算法实现的路径:
推荐一篇文章,具体介绍pelt算法的实现。文章连接:进程调度之pelt算法 - 知乎
1.1 PELT 接口函数
Linux 内核的SMP 负载均衡机制与绿色节能调度器会使用以下PELT接口函数来计算进程和处理器的负载。
1.1.1 以下函数用于更新调度实体se 的负载信息。
<kernel/sched/pelt.h>
int __update_load_avg_se(u64 now, struct cfs_rq *cfs_rq, struct sched_entity *se);
1.1.2 以下函数用于更新CFS就绪队列的负载信息。
int __update_load_avg_cfs_rq(u64 now, struct cfs_rq *cfs_rq);
1.1.3 以下函数用于更新一个调度实体在阻塞状态下的负载信息。
int __update_load_avg_blocked_se(u64 now, struct sched_entity *se);
1.1.4 以下函数用于获取CFS就绪队列的量化负载runnable_load_avg,该值主要用于SMP负载均衡。和后面介绍负载均衡有关系
static unsigned long cpu_load(struct rq *rq)
{
return cfs_rq_load_avg(&rq->cfs);
}
有的版本,不是这个函数接口。
1.1.5 以下函数用于获取进程的实际能力util_avg,该值主要用于绿色节能调度器和CPU调频。
static inline unsigned long task_util(struct task_struct *p)
{
return READ_ONCE(p->se.avg.util_avg);
}
1.1.6 以下函数用于获取CPU的实际能力util_avg,该值主要用于绿色节能调度器和CPU调频。
static inline unsigned long cpu_util(int cpu)
{
struct cfs_rq *cfs_rq;
unsigned int util;
cfs_rq = &cpu_rq(cpu)->cfs;
util = READ_ONCE(cfs_rq->avg.util_avg);
if (sched_feat(UTIL_EST))
util = max(util, READ_ONCE(cfs_rq->avg.util_est.enqueued));
return min_t(unsigned long, util, capacity_orig_of(cpu));
}
1.2 什么是CPU负载(load)
CPU负载是一个很容易和CPU利用率(utility)混淆的概念。CPU利用率是CPU忙闲的比例,例如在一个周期为1000ms的窗口中观察CPU的情况,如果500ms的时间在执行任务,500ms的时间处于idle状态,那么在这个窗口中CPU的利用率是50%。
在CPU利用率没有达到100%的时候,利用率基本上等于负载,一旦当CPU利用率达到了100%的时候,利用率其实是无法给出CPU负载的状况,因为大家的利用率都是100%,利用率相等,但是并不意味着CPUs的负载也是相等的,因为这时候不同CPU上runqueue中等待执行的任务数目不同,直觉上runque上挂着10任务的CPU承压比挂着5个任务的CPU的负载要更重一些。因此,早期的CPU负载是使用runqueue深度来描述的。
显然,仅仅使用runqueue深度来表示CPU负载是一个很粗略的概念,我们可以举一个简单的例子:当前CPU A和CPU B上都挂了1个任务,但是A上挂的任务是一个重载任务,而B上挂的是一个经常sleep的轻载任务,那么仅仅从runqueue深度来描述CPU负载就有失偏颇了。因此,现代调度器往往使用CPU runqueue上task load之和来表示CPU load。这样,对CPU负载的跟踪就变成了对任务负载的跟踪。
3.8版本的linux内核引入了PELT算法来跟踪每一个sched entity的负载,把负载跟踪的算法从per-CPU进化到per-entity。PELT算法不但能知道CPU的负载,而且知道负载来自哪一个调度实体,从而可以更精准的进行负载均衡。
1.3 什么是均衡
对于负载均衡而言,并不是把整个系统的负载平均的分配到系统中的各个CPU上。实际上,我们还是必须要考虑系统中各个CPU的算力,让CPU获得和其算力匹配的负载。例如在一个6个小核+2个大核的系统中,整个系统如果有800的负载,那么每个CPU上分配100的负载其实是不均衡的,因为大核CPU可以提供更强的算力。
什么是CPU算力(capacity),所谓算力就是描述CPU的能够提供的计算能力。在同样的频率下,一个微架构是A77的CPU显然算力要大于A57的CPU。如果CPU的微架构都是一样的,那么一个最大频率是2.2GHz的CPU算力肯定是大于最大频率是1.1GHz的CPU。因此,确定了微架构和最大频率,一个CPU的算力就基本确定了。Cpufreq系统会根据当前的CPU util来调节CPU当前的运行频率,但这并不能改变CPU算力。只有当CPU最大运行频率发生变化的时候(例如触发温控,限制了该CPU的最大频率),CPU的算力才会随之变化。
此外,本文主要描述CFS任务的均衡(RT的均衡不考虑负载,是在另外的维度),因此在考虑CPU算力的时候,需要把CPU用于执行rt和irq的算力去掉,使用该CPU可用于CFS的算力。因此,CFS任务均衡中使用的CPU算力其实一个不断变化的值,需要经常更新。为了让CPU算力和任务负载可以对比,实际上我们采用了归一化的方式,即系统中处理能力最强的CPU运行在最高频率的算力是1024,其他的CPU算力根据微架构和运行频率响应的调整其算力。
有了任务负载就可以得到CPU负载,配合系统中各个CPU的算力,看起来我们就可以完成负载均衡的工作,然而事情没有那么简单,当负载不均衡的时候,任务需要在CPU之间迁移,不同形态的迁移会有不同的开销。例如一个任务在小核cluster上的CPU之间的迁移所带来的性能开销一定是小于任务从小核cluster的CPU迁移到大核cluster的开销。因此,为了更好的执行负载均衡,我们需要构建和CPU拓扑相关的数据结构,也就是调度域和调度组的概念。
二、调度域(sched domain)和调度组(sched group)
负载均衡的复杂性主要和复杂的系统拓扑有关。由于当前CPU很忙,我们把之前运行在该CPU上的一个任务迁移到新的CPU上的时候,如果迁移到新的CPU是和原来的CPU在不同的cluster中,性能会受影响(因为会cache flush)。
但是对于SMT(超线程)架构,cpu共享cache,这时候超线程之间的任务迁移将不会有特别明显的性能影响。NUMA上任务迁移的影响又不同,我们应该尽量避免不同NUMA node之间的任务迁移,除非NUMA node之间的均衡达到非常严重的程度。
总之,一个好的负载均衡算法必须适配各种cpu 拓扑结构。为了解决这些问题,linux内核引入了sched_domain的概念。
内核中struct sched_domain来描述调度域,其主要的成员如下:
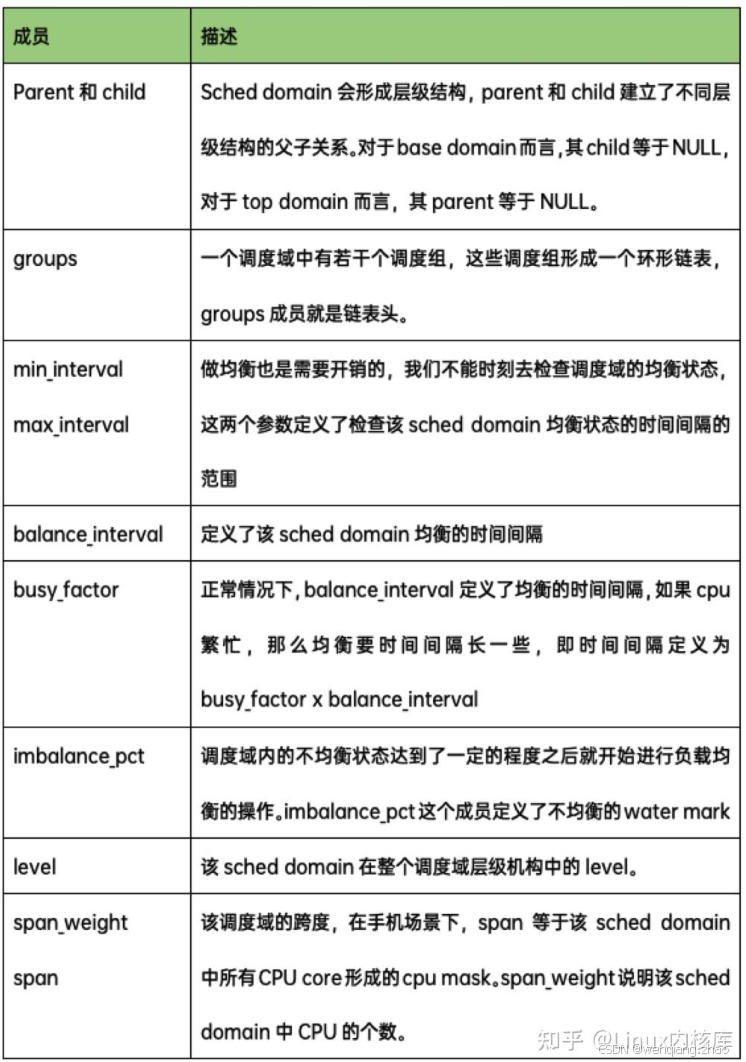
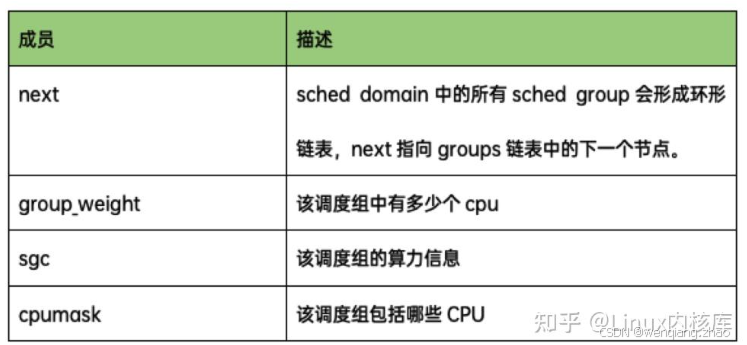
一旦形成了调度域,那么负载均衡就被限制在了该调度域内,在该调度域内进行均衡的时候不考虑系统中其他调度域的CPU负载情况,只考虑该调度域内的sched group之间的负载是否均衡。对于base domain,其所属的sched group中只有一个cpu,对于更高level的sched domain,其所属的sched group中可能会有多个cpu core。内核中struct sched_group来描述调度组,其主要的成员如下:
三、负载均衡的软件架构
负载均衡的整体软件结构图如下:
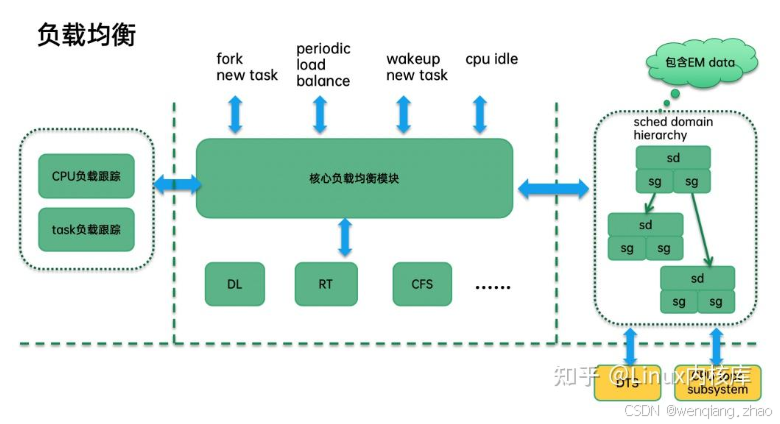
负载均衡模块主要分两个软件层次:核心负载均衡模块和class-specific均衡模块。内核对不同的类型的任务有不同的均衡策略,普通的CFS(complete fair schedule)任务和RT、Deadline任务处理方式是不同的,由于篇幅原因,本文主要讨论CFS任务的负载均衡。
为了更好的进行CFS任务的均衡,系统需要跟踪任务负载和CPU负载。跟踪任务负载是主要有两个原因:
(1)判断该任务是否适合当前CPU算力。
(2)如果判定需要均衡,那么需要在CPU之间迁移多少的任务才能达到平衡?有了任务负载跟踪模块,这个问题就比较好回答了
对CPU负载的跟踪不仅要考虑每一个CPU的负载,还要汇聚cluster上所有负载,方便计算cluster之间负载的不均衡状况。
为了更好的进行高效的均衡,我们还需要构建调度域的层级结构(sched domain hierarchy),图中显示的是二级结构。手机场景多半是二级结构,支持NUMA的服务器场景可能会形成更复杂的结构。通过DTS和CPU topo子系统,我们可以构建sched domain层级结构,用于具体的均衡算法。
有了上面描述的基础设施,那么什么时候进行负载均衡呢?这主要和调度事件相关,当发生任务唤醒、任务创建、tick到来等调度事件的时候,我们可以检查当前系统的不均衡情况,并酌情进行任务迁移,以便让系统负载处于平衡状态。
四、调度域和调度组的初始化
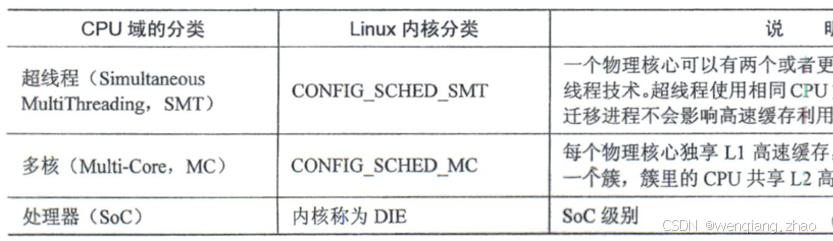
根据系统的内存和高速缓存的布局,CPU域可分为如下几类:根据书籍《奔跑吧,Linux内核》
Linux 通过数据结构sched_domain_topology_level来描述CPU的层次关系,简称为SDTL:
//kernel/include/linux/sched/topology.h

// 用于描述 CPU 的层级关系
struct sched_domain_topology_level {
	sched_domain_mask_f mask;			// 函数指针,用于指定某个 SDTL 的 cpumask 位图
	// sd_flags 函数指针里指定了该调度层级的标志位
	sched_domain_flags_f sd_flags;		// 函数指针,用于指定某个 SDTL 的标志位
	int		    flags;
	int		    numa_level;
	struct sd_data      data;
#ifdef CONFIG_SCHED_DEBUG
	char                *name;
#endif
};
另外,内核默认定义了一个数组default_topology[]来概括CPU物理域的层次结构:
//kernel/kernel/sched/topology.c

// CPU 拓扑关系,从下往上
static struct sched_domain_topology_level default_topology[] = {
#ifdef CONFIG_SCHED_SMT		// 超线程
	// cpu_smt_mask() 函数描述了 SMT 层级的 CPU 位图组成方式
	{ cpu_smt_mask, cpu_smt_flags, SD_INIT_NAME(SMT) },
#endif
#ifdef CONFIG_SCHED_MC		// 多核
	// cpu_coregroup_mask() 函数描述了 MC 层级的 CPU 位图组成方式
	{ cpu_coregroup_mask, cpu_core_flags, SD_INIT_NAME(MC) },
#endif						// 处理器
	// cpu_cpu_mask() 函数描述了 DIE 层级的 CPU 位图组成方式
	{ cpu_cpu_mask, SD_INIT_NAME(DIE) },
	{ NULL, },
};
从default_topology[]数组可知,系统默认支持DIE层级、SMT层级以及MC层级。另外,在调度域里划分调度组,使用sched_group来描述调度组,调度组是负载均衡调度的最小单位,在最低层级的调度域中,通常一个调度组描述一个CPU。
在一个支持NUMA架构的处理器中,假设它支持SMT技术,那么整个系统的调度域和调度组的关系如下图所示(它在默认调度层级中新增一个NUMA层级的调度域):
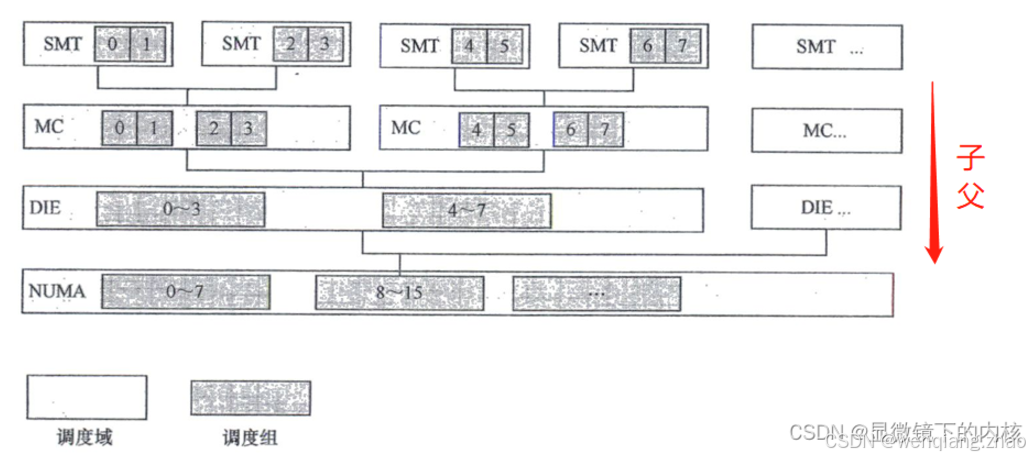
- DIE表示处理器封装,它是CPU拓扑结构中的一个层级,在多核处理器中,通常有多个物理处理器核心,组成一个封装
- MC 就是可以理解L2缓存是否共享
- SMT 就是可以理解L1缓存是否共享
在Linux内核中使用sched_domain数据结构来描述调度层级。在超大系统中系统会频繁访问调度域数据结构,为了提升系统的性能和可扩展性,调度域sched_domain数据结构采用Per-CPU变量来构建:
// 描述调度层级
struct sched_domain {
    // 父调度域指针,顶层调度域必须为 null 终止
    struct sched_domain *parent;
    // 子调度域指针,底层调度域必须为 null 终止
    struct sched_domain *child;
    // groups 指向该调度域的平衡组链表
    struct sched_group *groups;
    // 最小平衡间隔(毫秒)
    unsigned long min_interval;
    // 最大平衡间隔(毫秒)
    unsigned long max_interval;
    ...
};
下面举例来说明CPU调度域的拓扑关系,如下图所示,假设在一个4核处理器中,每个CPU拥有独立L1高速缓存且不支持超线程技术,4个物理CPU被分成两个簇Cluster0和Cluster1,每个簇包含两个物理CPU,簇中的CPU共享L2高速缓存。这文章的图片都是《奔跑吧,Linux内核》书籍上的。
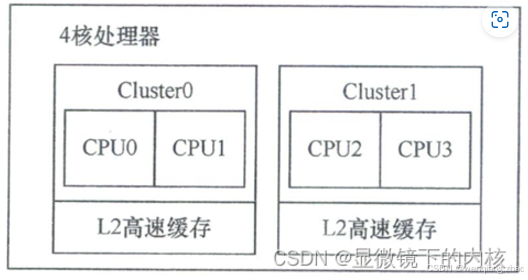
因为每个CPU内核只有一个运行线程,所以4核处理器没有SMT层级。簇由两个CPU组成,这两个CPU处于MC层级且是兄弟关系。整个处理器可以看作处于DIE层级,因此该处理器只有两个层级,即MC和DIE。根据上述原则,4核处理器的调度域和调度组的拓扑关系如下图所示:
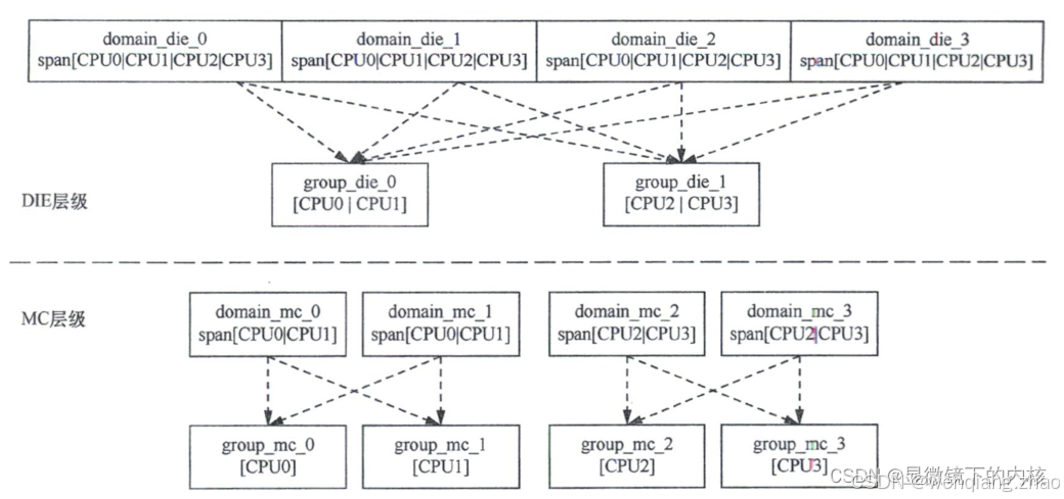
在每个SDTL都为每个CPU分配了对应的调度域和调度组,以CPU0为例:
- 对于DIE层级,CPU0对应的调度域是domain_die_0,该调度域管辖着4个CPU并包含两个调度组,分别为group_die_0和group_die_1
- 调度组group_die_0管辖CPU0和CPU1
- 调度组group_die_1管辖CPU2和CPU3
- 对于MC层级,CPU0对应的调度域是domain_mc_0,该调度域中管辖着CPU0和CPU1并包含两个调度组,分别为group_mc_0和group_mc_1
- 调度组group_mc_0管辖CPU0
- 调度组group_mc_1管辖CPU1
除此以外,4核处理器的调度域和调度组还有两层关系,如下图所示:
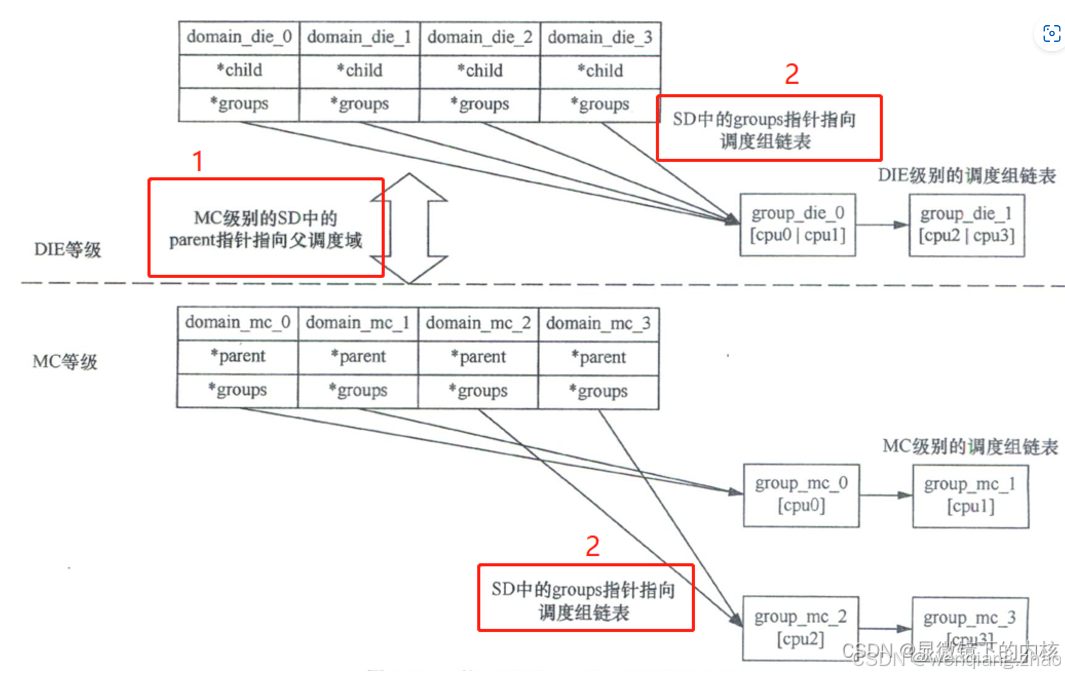
综上所述,为了提升系统的性能和可扩展性,sched_domain数据结构采用Per-CPU变量来构建,这样可以减少CPU之间的访问竞争。而sched_group数据结构则是调度域内共享的。
4.1 LLC调度域
在负载均衡算法中,我们常常需要快速找到系统中最高层级的并且具有高速缓存共享属性的调度域。通常在—个系统,我们把最后一级高速缓存(Last Level Cache,LLC)称为LLC。在调度域标志位中,SD_SHARE_PKG_RESOURCE标志位用于描述高速缓存的共享属性。因此,在调度域层级中,包含LLC的最高一级调度域称为LLC调度域。在Linux内核中实现一组特殊用途的指针,用来指向LLC调度域,这些指针是Per-CPU变量。查找和设置LLC调度域是在update_top_cache_domain()函数中实现的。在select_idle_cpu()等函数中会使用到LLC 调度域。
// kernel/kernel/sched/topology.c

// 指向 LLC 调度域
DEFINE_PER_CPU(struct sched_domain *, sd_llc);
// LLC 调度域包含多少个 CPU
DEFINE_PER_CPU(int, sd_llc_size);
// LLC 调度域第一个 CPU 的编号
DEFINE_PER_CPU(int, sd_llc_id);
DEFINE_PER_CPU(struct sched_domain_shared *, sd_llc_shared);
DEFINE_PER_CPU(struct sched_domain *, sd_numa);
DEFINE_PER_CPU(struct sched_domain *, sd_asym_packing);
// 指向第一个包含不同 CPU 架构的调度域,主要用于大/小核架构
DEFINE_PER_CPU(struct sched_domain *, sd_asym_cpucapacity);
DEFINE_STATIC_KEY_FALSE(sched_asym_cpucapacity);

// 查找和设置 LLC 调度域
static void update_top_cache_domain(int cpu)
{
    ...
}
LLC调度域,按照自己的理解讲,LLC调度域是最后一级高速缓存,即L2缓存或者L3缓存,换成调度域的专业术语,即MC调度域或者DIE调度域。
4.2 建立CPU调度域拓扑关系
start_kernel()->
rest_init()->
kernel_init()->
kernel_init_freeable()->
sched_init_smp()->
sched_init_domains()
//kernel/kernel/sched/topology.c

int sched_init_domains(const struct cpumask *cpu_map)
{
        int err;

        zalloc_cpumask_var(&sched_domains_tmpmask, GFP_KERNEL);
        zalloc_cpumask_var(&sched_domains_tmpmask2, GFP_KERNEL);
        zalloc_cpumask_var(&fallback_doms, GFP_KERNEL);

        arch_update_cpu_topology();
        ndoms_cur = 1;
        doms_cur = alloc_sched_domains(ndoms_cur);
        if (!doms_cur)
                doms_cur = &fallback_doms;
        cpumask_and(doms_cur[0], cpu_map, housekeeping_cpumask(HK_FLAG_DOMAIN));
        err = build_sched_domains(doms_cur[0], NULL);//开始建立CPU拓扑图
        register_sched_domain_sysctl();

        return err;
}
这里总结以下,不具体展示代码如何创建调度域和调度组的实现,如果感兴趣,就去看《奔跑吧,linux 内核》。这里只说总结:
- 调度域变量和调度组是PER-CPU变量;此处的调度组和进程关系里的任务组(task_group)不是一个概念.
- 层级关系:由低到高,由子到父:SMT->MC->DIE
五、负载均衡的触发
5.1 负载均衡机制从注册软中断开始,每次系统处理调度节拍会检查当前是否需要处理负载均衡。
start_kernel()->
sched_init()->
init_sched_fair_class()
//kernel/kernel/sched/fair.c

__init void init_sched_fair_class(void)
{
#ifdef CONFIG_SMP
        open_softirq(SCHED_SOFTIRQ, run_rebalance_domains);

#ifdef CONFIG_NO_HZ_COMMON
        nohz.next_balance = jiffies;
        nohz.next_blocked = jiffies;
        zalloc_cpumask_var(&nohz.idle_cpus_mask, GFP_NOWAIT);
#endif
#endif /* SMP */

}
run_rebalance_domains()->rebalance_domains(),rebalance_domains 是负载均衡的核心入口。
//kernel/kernel/sched/fair.c

static void rebalance_domains(struct rq *rq, enum cpu_idle_type idle)
{
        int continue_balancing = 1;
        int cpu = rq->cpu;
        int busy = idle != CPU_IDLE && !sched_idle_cpu(cpu);
        unsigned long interval;
        struct sched_domain *sd;
        /* Earliest time when we have to do rebalance again */
        unsigned long next_balance = jiffies + 60*HZ;
        int update_next_balance = 0;
        int need_serialize, need_decay = 0;
        u64 max_cost = 0;

        rcu_read_lock();
        for_each_domain(cpu, sd) {

.....  load_balance(cpu, rq, sd, idle, &continue_balancing);//简化了


}
load_balance(cpu, rq, sd, idle, &continue_balancing),是负载均衡的核心函数。
负载均衡机制从注册软中断开始,每次系统处理调度节拍时会检查当前是否需要处理负载均衡。负载均衡的流程如图所示:
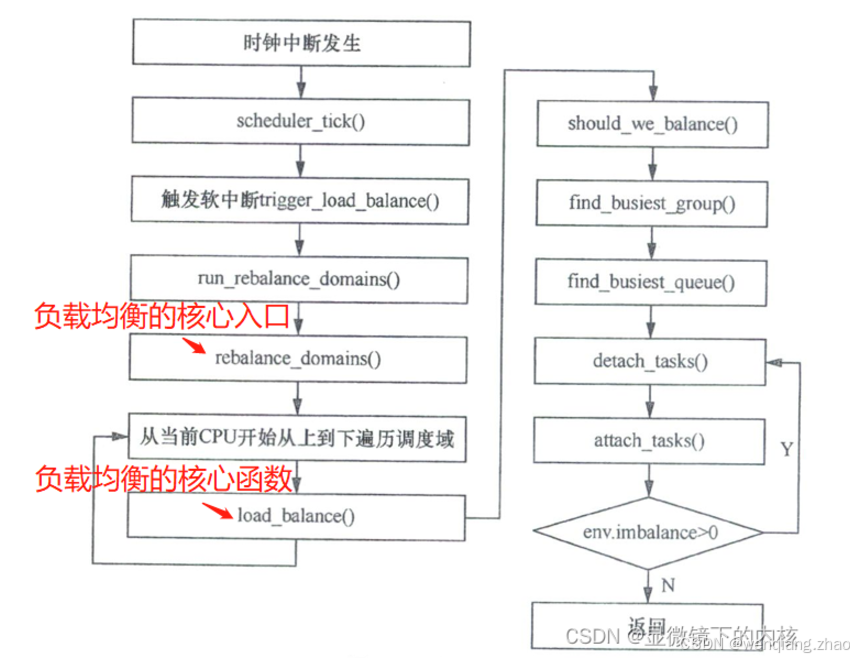
should_we_balance():判断当前CPU是否可以做负载均衡,如果可以,返回true.
find_busiest_group(): 查找最繁忙的调度组
find_busiest_queue():在最繁忙的调度组中,查找最繁忙的队列,即最繁忙的CPU。
detach_tasks():查找最繁忙的CPU就绪队列中,哪些进程可以被迁出。
attach_tasks():主要是把detach_tasks 分离出来的进程,重新添加到就绪队列中。
上面各个函数的具体实现,可以去参考书籍《奔跑吧,Linux内核》,内容太多,只写框架。
5.2 总结
至此,load_balance()函数大致框架已介绍完毕,主要流程如下:
- 负载均衡以当前CPU开始,自下而上地遍历调度域,从最底层的调度域开始做负载均衡。
- 允许做负载均衡的首要条件是当前CPU是该调度域中第一个CPU,或者当前CPU是空闲CPU。详见should_we_balance()函数。
- 在调度域中查找最繁忙的调度组,更新调度域和调度组的相关信息,计算出该调度域的不均衡负载值(imbalance)。
- 在最繁忙的调度组中查找最繁忙的CPU,并把最繁忙CPU中的进程迁移到当前CPU上,迁移的负载量为不均衡负载值。
负载均很的计算和额定算力,cluster 的支持能力等,都在5.1函数中进行判断比较,做出负载均衡的措施。
六、负载均衡场景分析
1、整体的场景描述
在linux内核中,为了让任务均衡的分布在系统的所有CPU上,我们主要考虑下面三个场景:
(1)负载均衡(load balance)。通过搬移cpu runqueue上的任务,让各个CPU上的负载匹配CPU算力。
(2)任务放置(task placement)。当阻塞的任务被唤醒的时候,确定该任务应该放置在那个CPU上执行。
(3)主动均衡(active upmigration)。当一个低算力CPU的runqueue中出现misfit task的时候,如果该任务持续执行,那么负载均衡无能为力,因为它只负责迁移runnable状态的任务。这种场景下,active upmigration可以把当前正在运行的misfit task向上迁移到算力更高的CPU上去。
2、Load balance
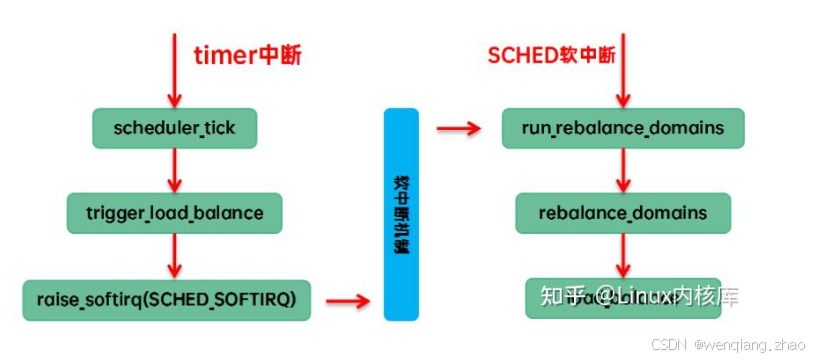
(1)在tick中触发load balance。我们称之tick load balance或者periodic load balance。具体的代码执行路径是:
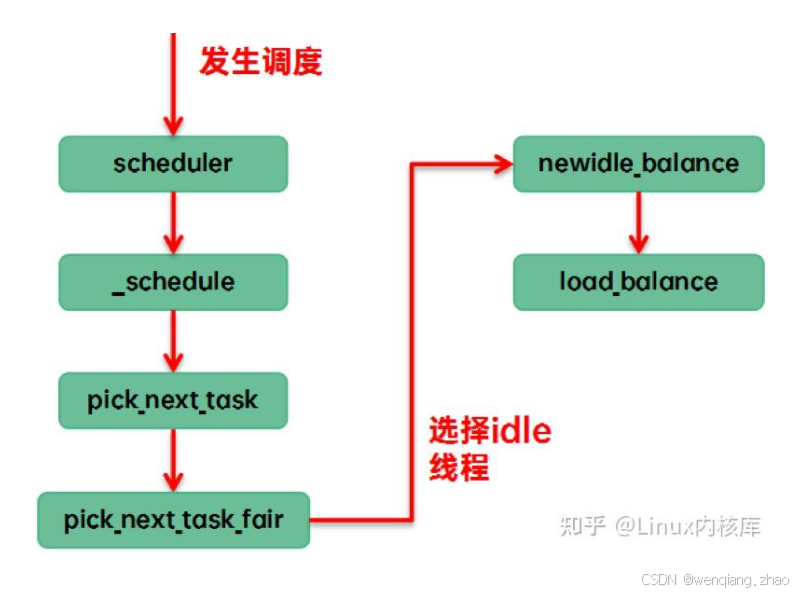
(2)调度器在pick next的时候,当前cfs runque中没有runnable,只能执行idle线程,让CPU进入idle状态。我们称之new idle load balance。具体的代码执行路径是:
(3)其他的cpu已经进入idle,本CPU任务太重,需要通过ipi将其idle的cpu唤醒来进行负载均衡。我们称之idle load banlance,具体的代码执行路径是:
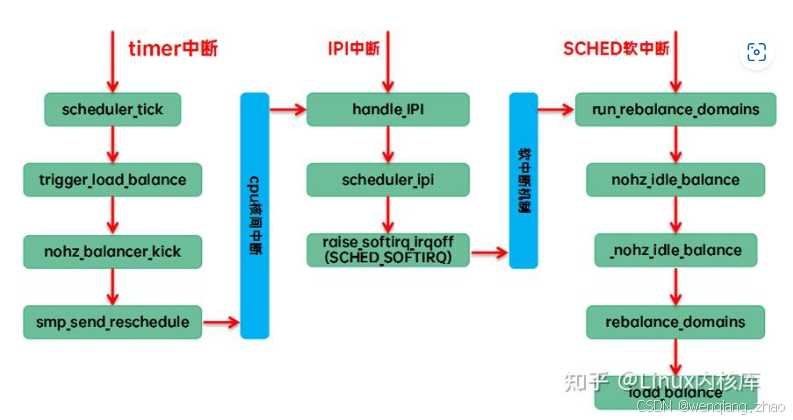
如果没有dynamic tick特性,那么其实不需要进行idle load balance,因为tick会唤醒处于idle的cpu,从而周期性tick就可以覆盖这个场景。
3、Task placement
任务放置主要发生在:
(1)唤醒一个新fork的线程;
(2)Exec一个线程的时候;
(3)唤醒一个阻塞的进程。
在上面的三个场景中都会调用select_task_rq来为task选择一个适合的CPU core。这是个wake affine 特性有关,这个放在后面一篇文章讲解。
4、Active upmigration
主动迁移是Load balance的一种特殊场景。在负载均衡中,只要运用适当的同步机制(持有一个或者多个rq lock),runnable的任务可以在各个CPU runqueue之间移动,然而running的任务是例外,它不挂在CPU runqueue中,load balance无法覆盖。为了能够迁移running状态的任务,内核提供了Active upmigration的方法(利用stop machine调度类)。
七、其他需要考虑的事项
之所以要进行负载均衡主要是为了系统整体的throughput,避免出现一核有难,七核围观的状况。然而,进行负载均衡本身需要额外的算力开销,为了降低开销,我们为不同level的sched domain定义了时间间隔,不能太密集的进行负载均衡。之外,我们还定义了不均衡的门限值,也就是说domain的group之间如果有较小的不均衡,我们也是可以允许的,超过了门限值才发起负载均衡的操作。很显然,越高level的sched domain其不均衡的threashhold越高,越高level的均衡会带来更大的性能开销。
在引入异构系统之后,任务在placement的时候可以有所选择。如果负载比较轻,或者该任务对延迟要求不高,我们可以放置在小核CPU执行,如果负载比较重或者该该任务和用户体验相关,那么我们倾向于让它在算力更高的CPU上执行。为了应对这种状况,内核引入了misfit task的概念。一旦任务被标记了misfit task,那么负载均衡算法要考虑及时的将该任务进行upmigration,从而让重载任务尽快完成,或者提升该任务的执行速度,从而提升用户体验。
除了性能,负载均衡也会带来功耗的收益。例如系统有4个CPU,共计8个进入执行态的任务。这些任务在4个CPU上的排布有两种选择:
(1)全部放到一个CPU上;
(2)每个CPU runqueue挂2个任务。
负载均衡算法会让任务均布,从而带来功耗的收益。虽然方案一中有三个CPU是处于idle状态的,但是那个繁忙CPU运行在更高的频率上。而方案二中,由于任务均布,CPU处于较低的频率运行,功耗会比方案一更低。
最后推荐一篇源码分析的文章:
更多推荐


 13
 0
- 0


 已为社区贡献2条内容

所有评论(0)