
基于Drissionpage和ddddocr库在自动化爬虫中的实际应用(包含少量数据处理和可视化步骤,比较综合)
某知名旅行网酒店数据采集与分析项目实现流程
1. 项目概述
本项目是一个自动化采集某程网站酒店数据并进行数据分析的系统。主要包含数据采集和数据可视化分析两个主要模块。*
2. 技术架构
编程语言:Python
- 主要依赖库:
- DrissionPage:用于网页自动化操作
- ddddocr:用于验证码识别
- pymysql:数据库操作
- pandas:数据处理
- matplotlib/seaborn:数据可视化
- loguru:日志记录*
3. 配置信息和登录功能
3.1 配置管理
-
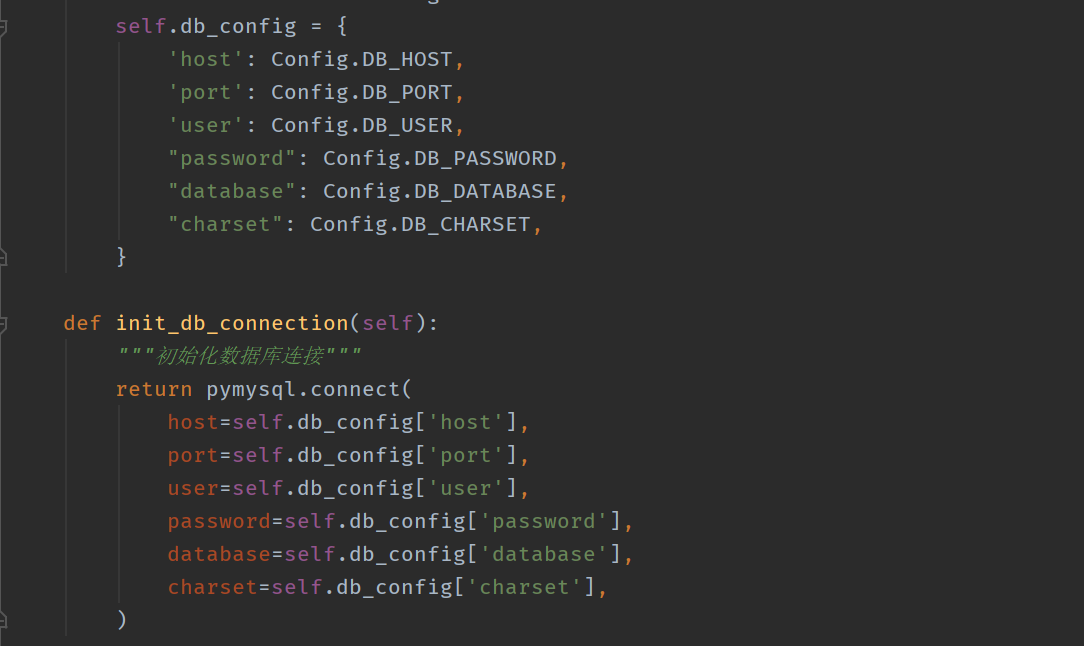
数据库配置(MySQL)
-
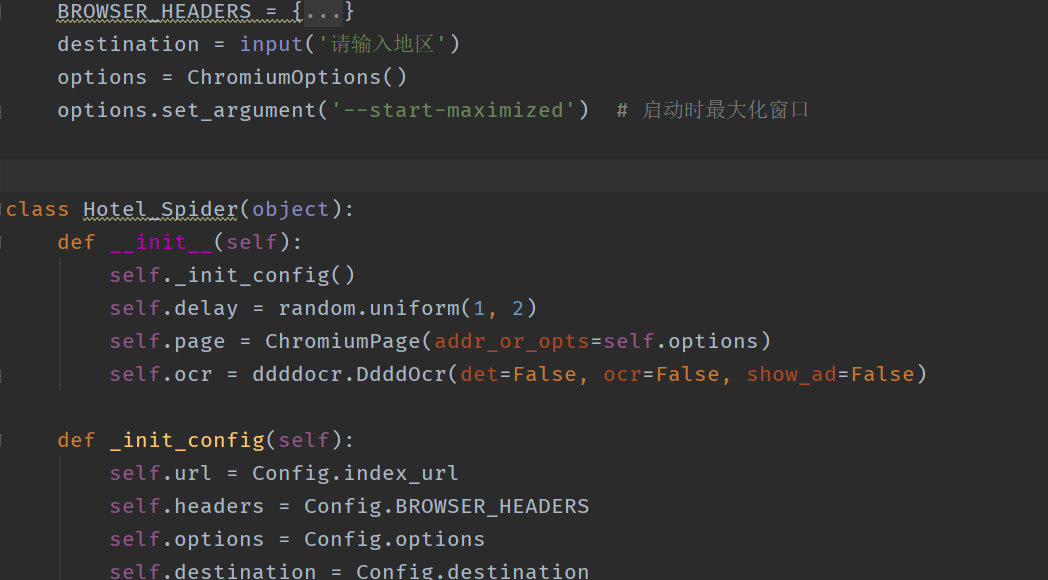
浏览器配置- 请求头配置
3.核心功能实现登录功能
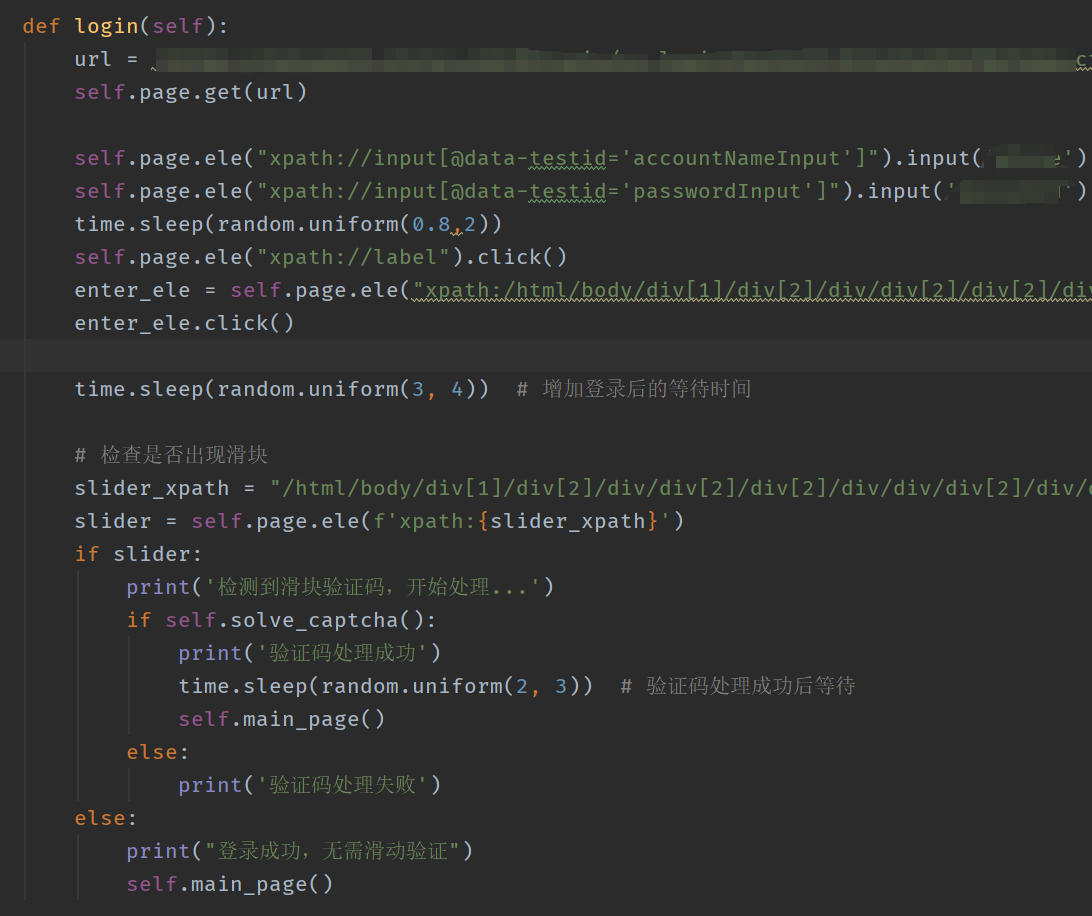
自动填写登录信息
 1.处理滑动验证码
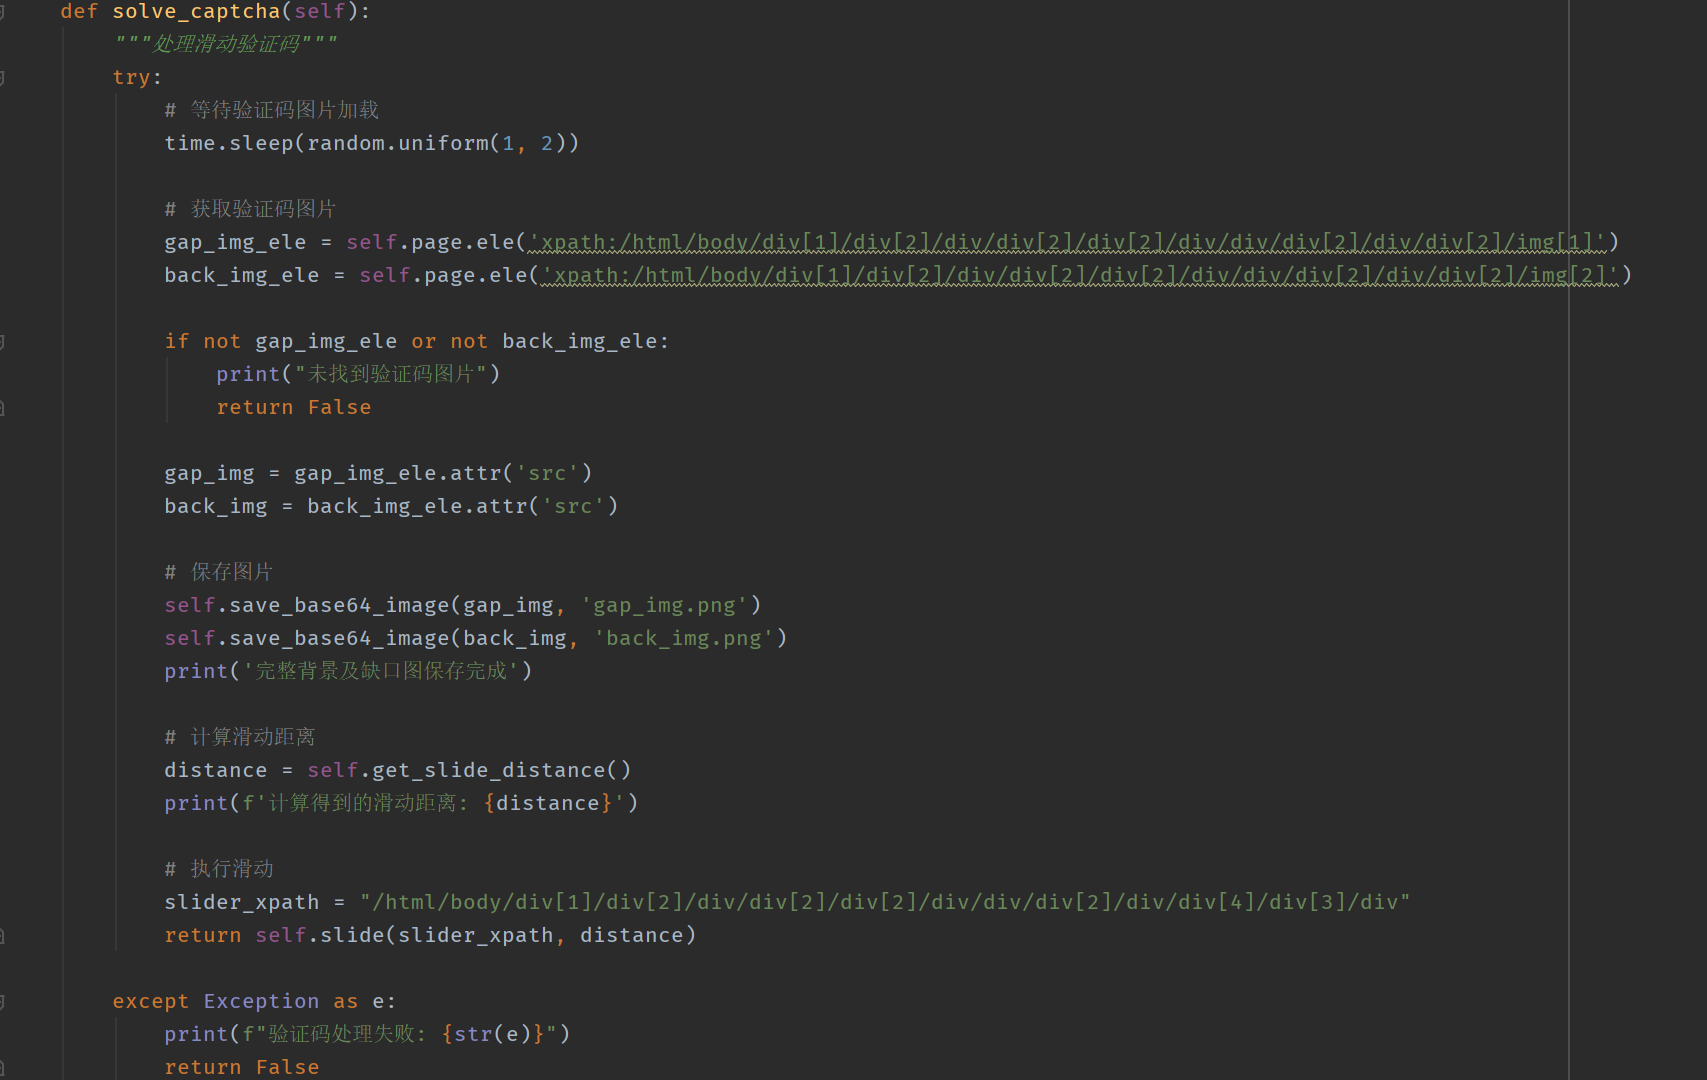
2. 定位验证码背景图和缺失图,本文基本都是使用xpath绝对定位,如果元素定位不到 请使用相对定位,或者使用
3. 语法://*[contains(@属性, ‘部分值’)]
4. 由于图片资源被base64编码需要有一个函数专门来拆分解码处理获取到图片二进制数据并写入本地
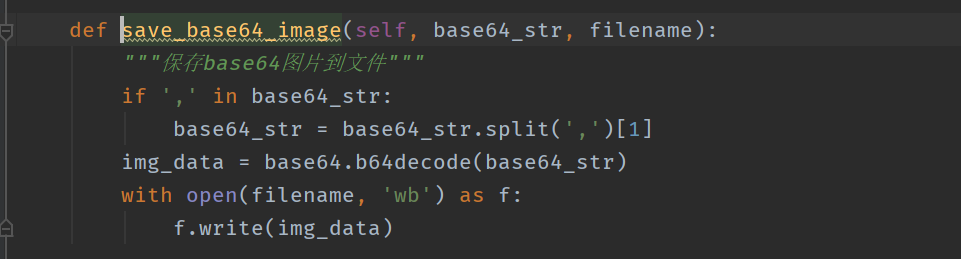 验证码识别与处理(使用github中的ddddocr图像识别库结合drissionpage中的actions动作链)
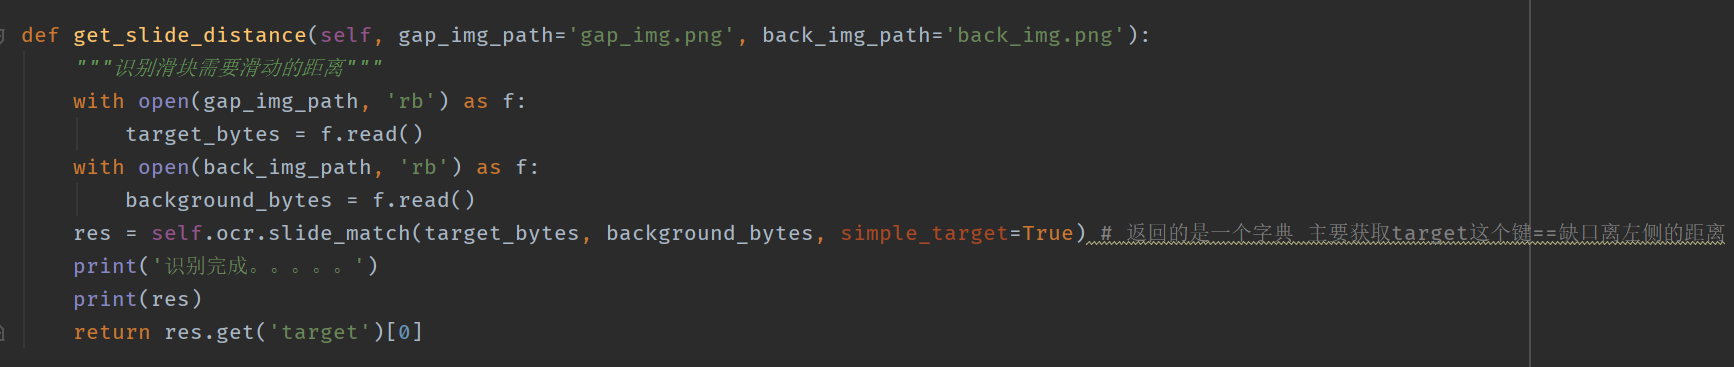
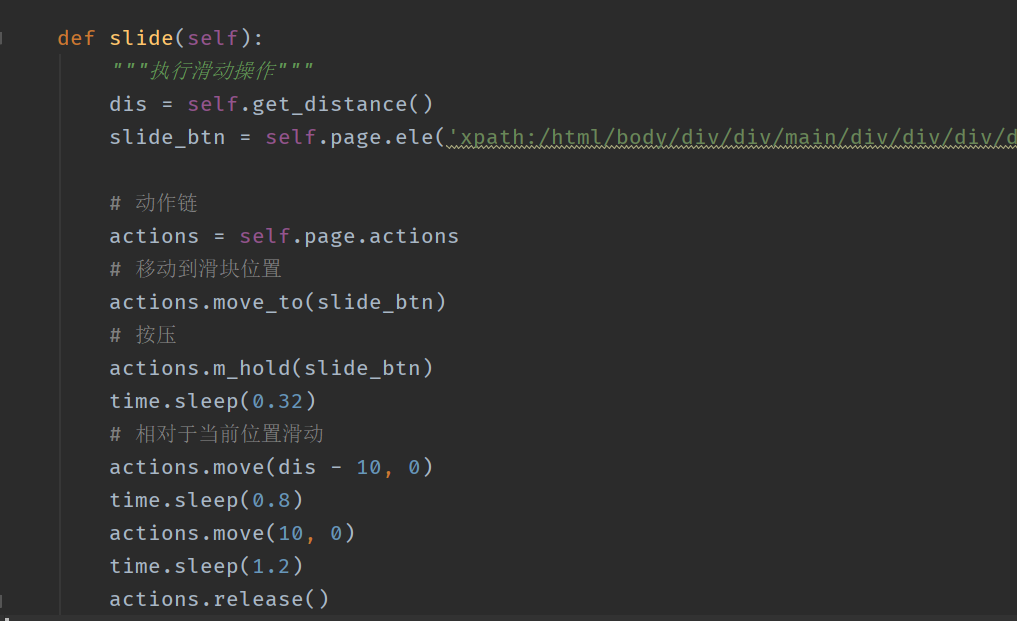
动作链使用主要分为四步:
1.定位拖动滑块的按钮
2.按压
3.拖动(这里尽量不要一次性拖动到目标位置会特别快,可以先超过正确位置然后缓慢倒退回来)
4.最后release松开鼠标即可
或者可以优化一下定义一个生成分段轨迹的函数
    def slide(self, slider_xpath, distance):
        """执行滑动操作"""
        slide_btn = self.page.ele(f'xpath:{slider_xpath}')
        if not slide_btn:
            print("未找到滑块按钮")
            return False

        # 动作链
        actions = self.page.actions
        # 移动到滑块位置
        actions.move_to(slide_btn)
        time.sleep(random.uniform(0.5, 1))

        # 按压
        actions.m_hold(slide_btn)
        time.sleep(random.uniform(0.8, 1.2))

        # 生成轨迹
        track = self.generate_track(distance)
        cur_x = 0
        for move in track:
            cur_x += move
            actions.move(move, 0)
            time.sleep(random.uniform(0.01, 0.03))

        # 最后微调
        time.sleep(random.uniform(0.1, 0.2))
        actions.move(3, 0)  # 向右微调
        time.sleep(random.uniform(0.05, 0.1))
        actions.move(-2, 0)  # 向左微调
        time.sleep(random.uniform(0.05, 0.1))

        # 松开鼠标
        actions.release()
        time.sleep(random.uniform(0.8, 1.2))
        return True

    def generate_track(self, distance):
        """生成人性化的滑动轨迹"""
        # 将距离分成2-3步
        steps = random.randint(2, 3)
        step_distance = distance / steps

        track = []
        for i in range(steps):
            if i == steps - 1:  # 最后一步
                move = distance - sum(track)  # 确保总距离准确
            else:
                move = int(step_distance * random.uniform(0.3, 0.8))  # 添加一些随机性
            track.append(move)

        # 添加一个小的抖动
        track.append(-random.randint(1.2, 1.5))
        track.append(random.randint(1.2, 1.5))

        return track
4.数据采集
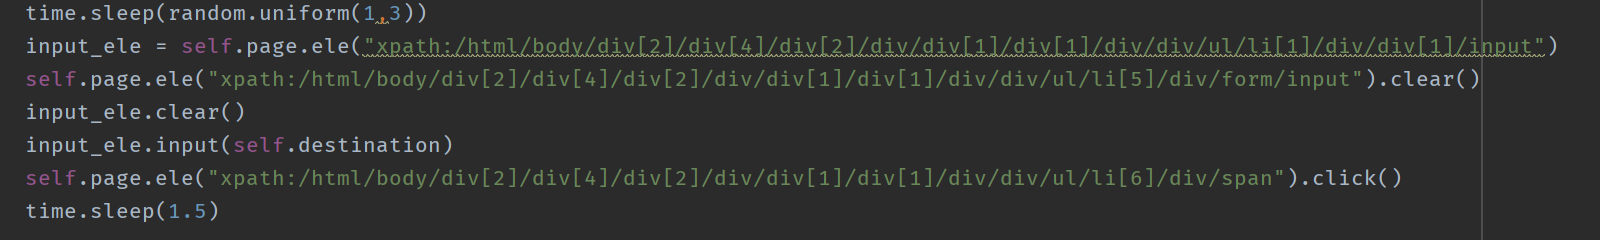
自动搜索指定地区酒店(这里很简单就是定位输入框清空一下,自动填入,并搜索即可)
-
页面滚动加载更多数据
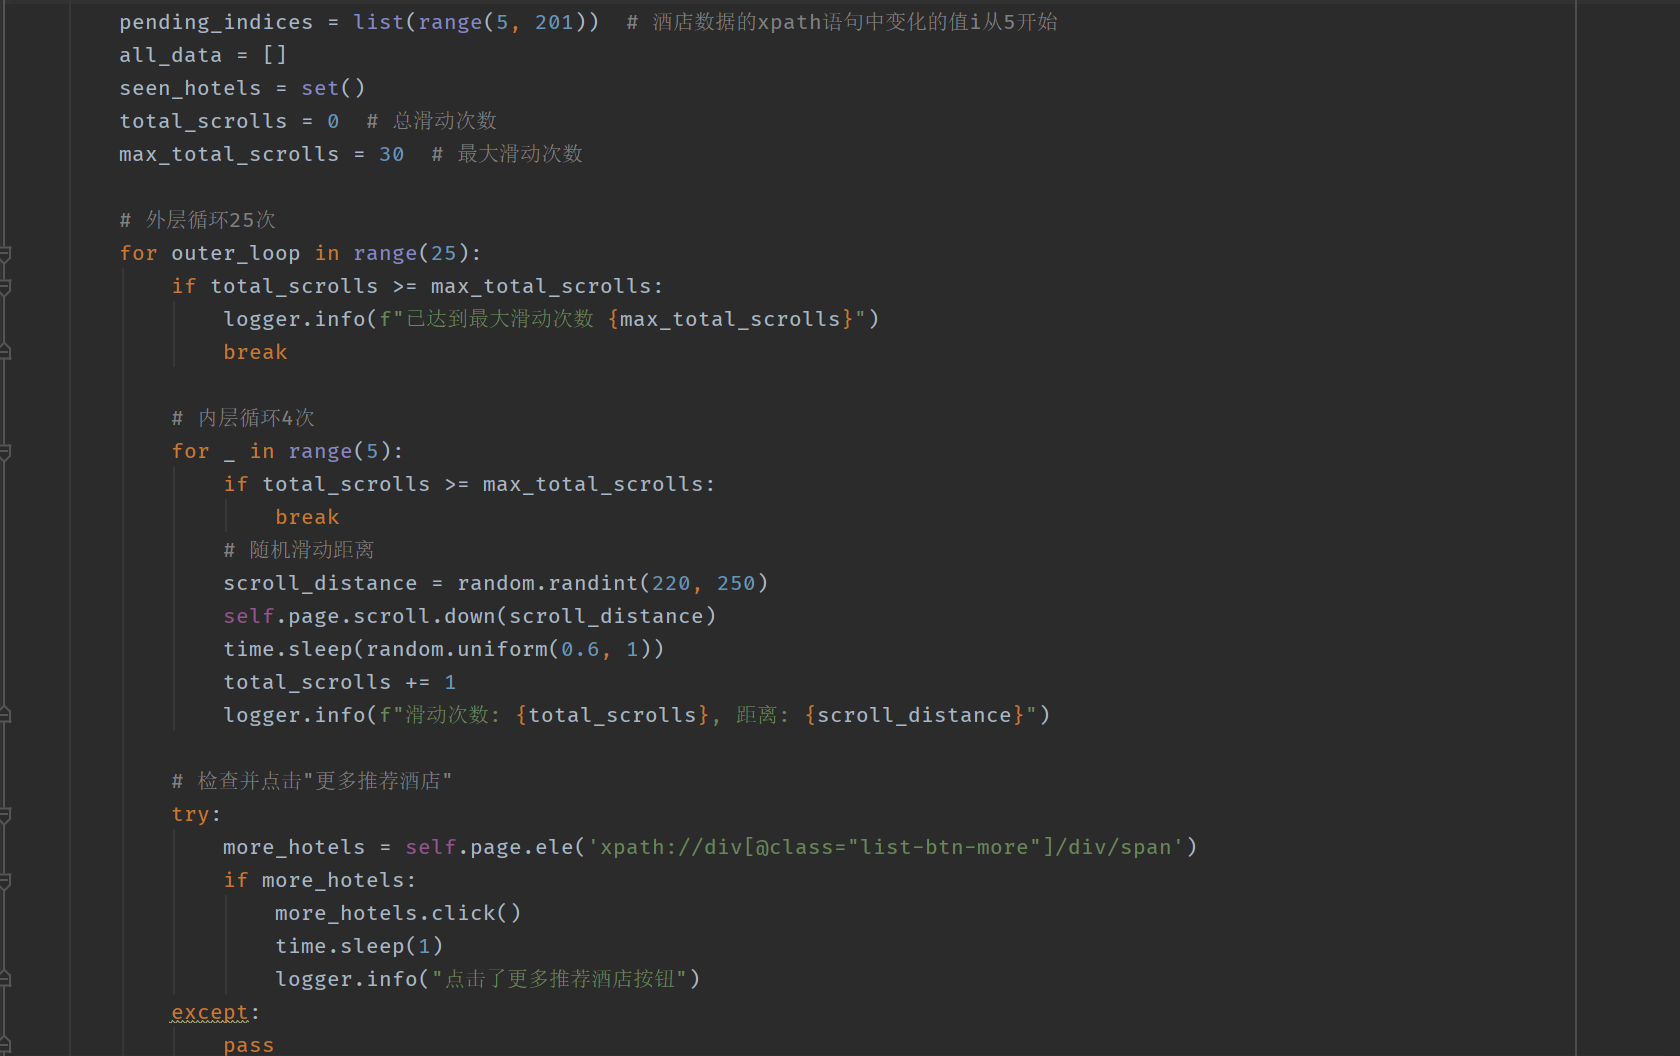
由于页面是必须下拉点击’搜索更多酒店’才可以加载出来数据,:
1.一开始是打算边滚动边通过xpath定位,但是xpath中每个标签对应的i值并不好控制,因为每次滚动不能保证展示的数据都是相同的,还必须使用异常处理跳过定位不到元素报的错误,程序必须再下滑再次定位,比较耗时。
2.最后决定,开始定位元素前给程序设定一个下滑最大次数,同时可以给程序设定一个i的范围固定想要爬取多少个酒店,在我们下滑到合适位置后,再一次性的定位所有元素,注意每次滑动的距离不能相同,速度不能太快,否则滑动可能会失效。
-
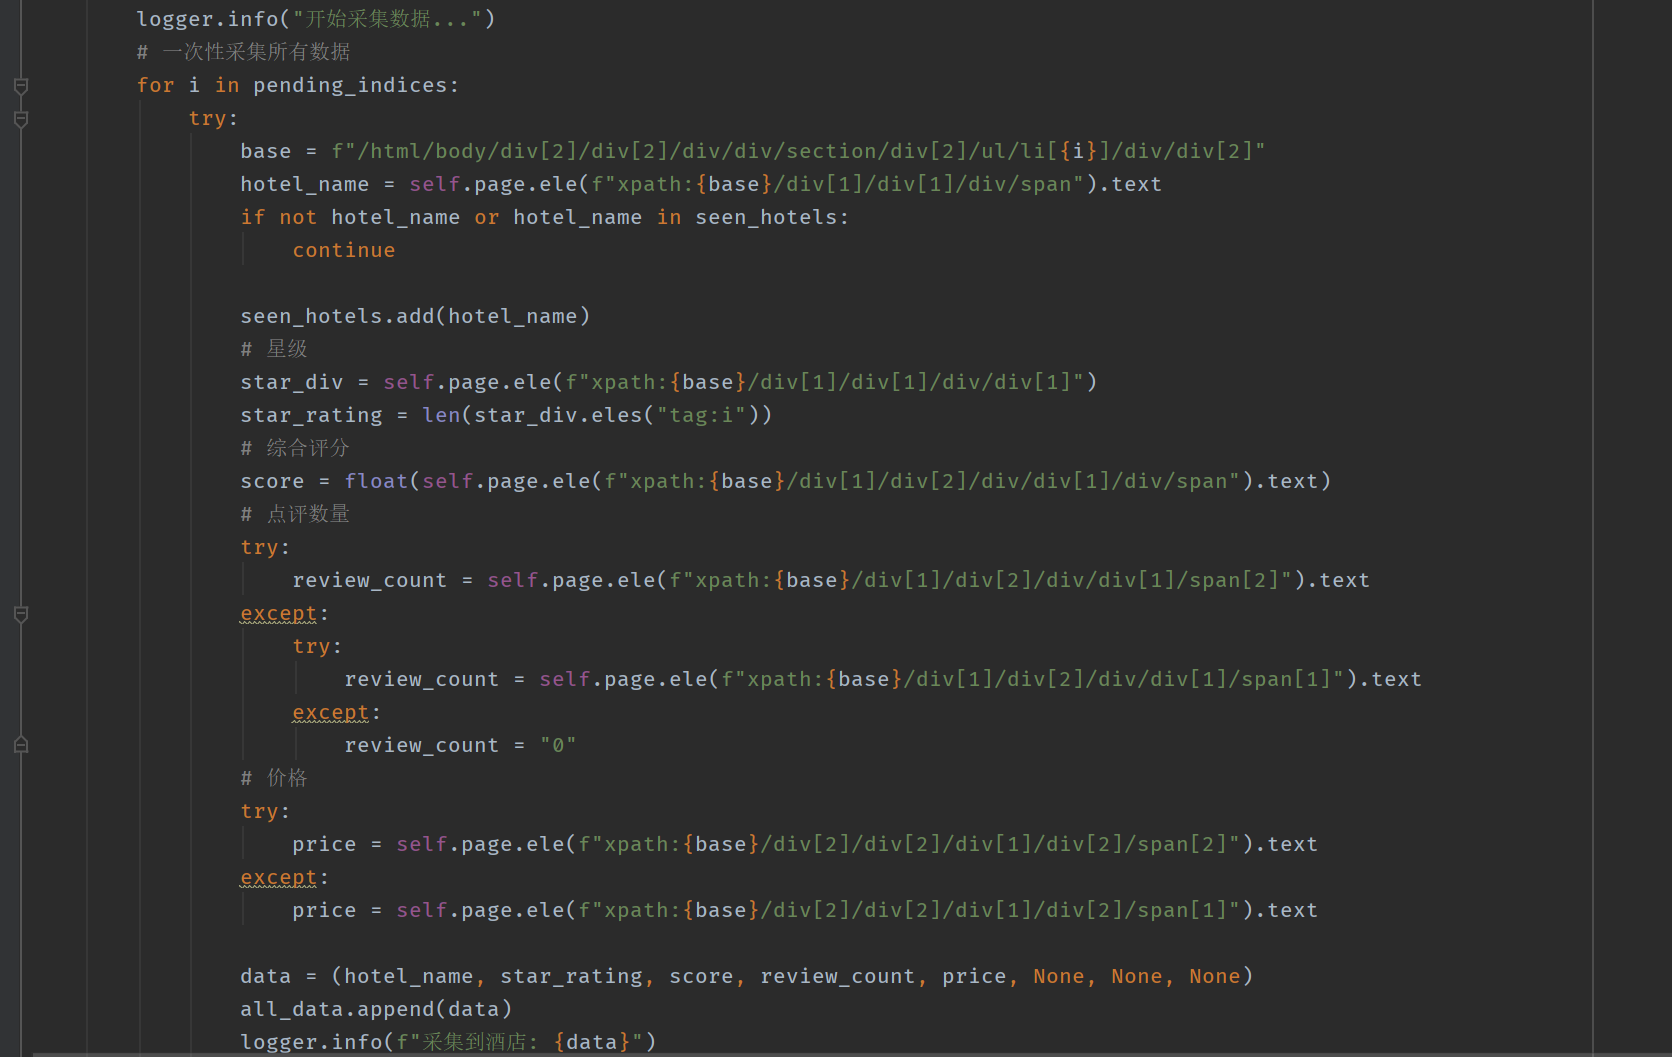
提取酒店信息(价格、评分、星级等)
-
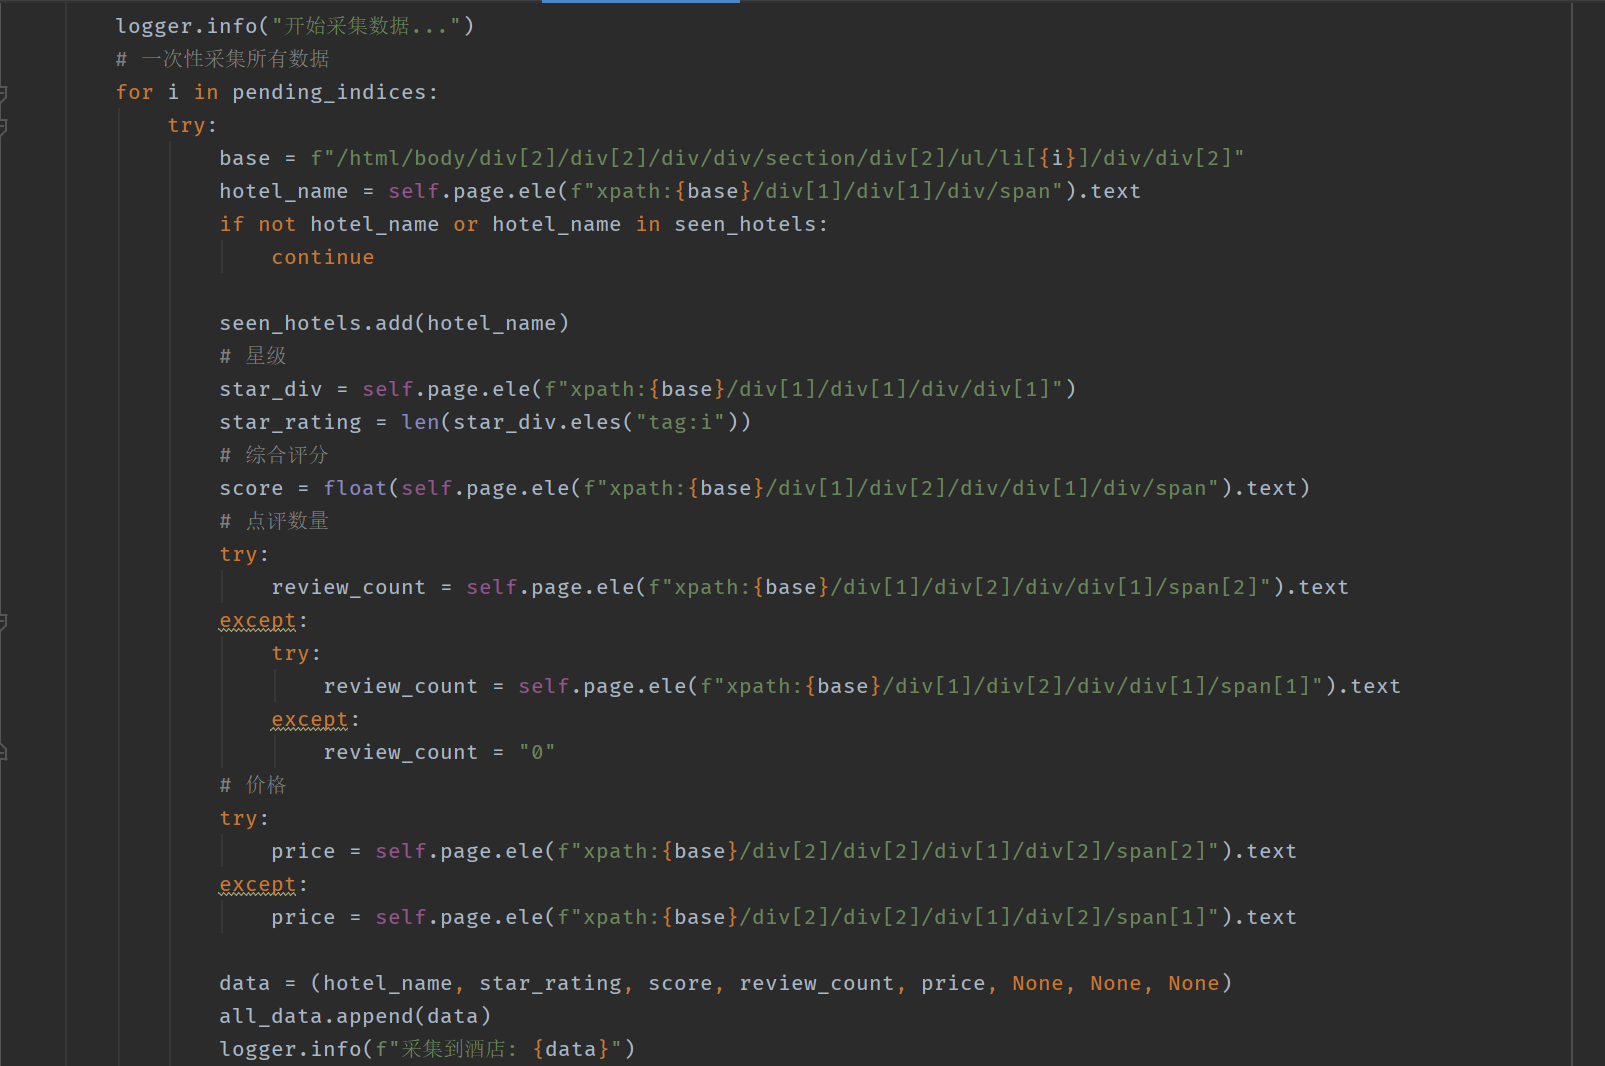
这种一次性定位所有目标元素相较于第一种方法不要对数据进行去重
数据存储
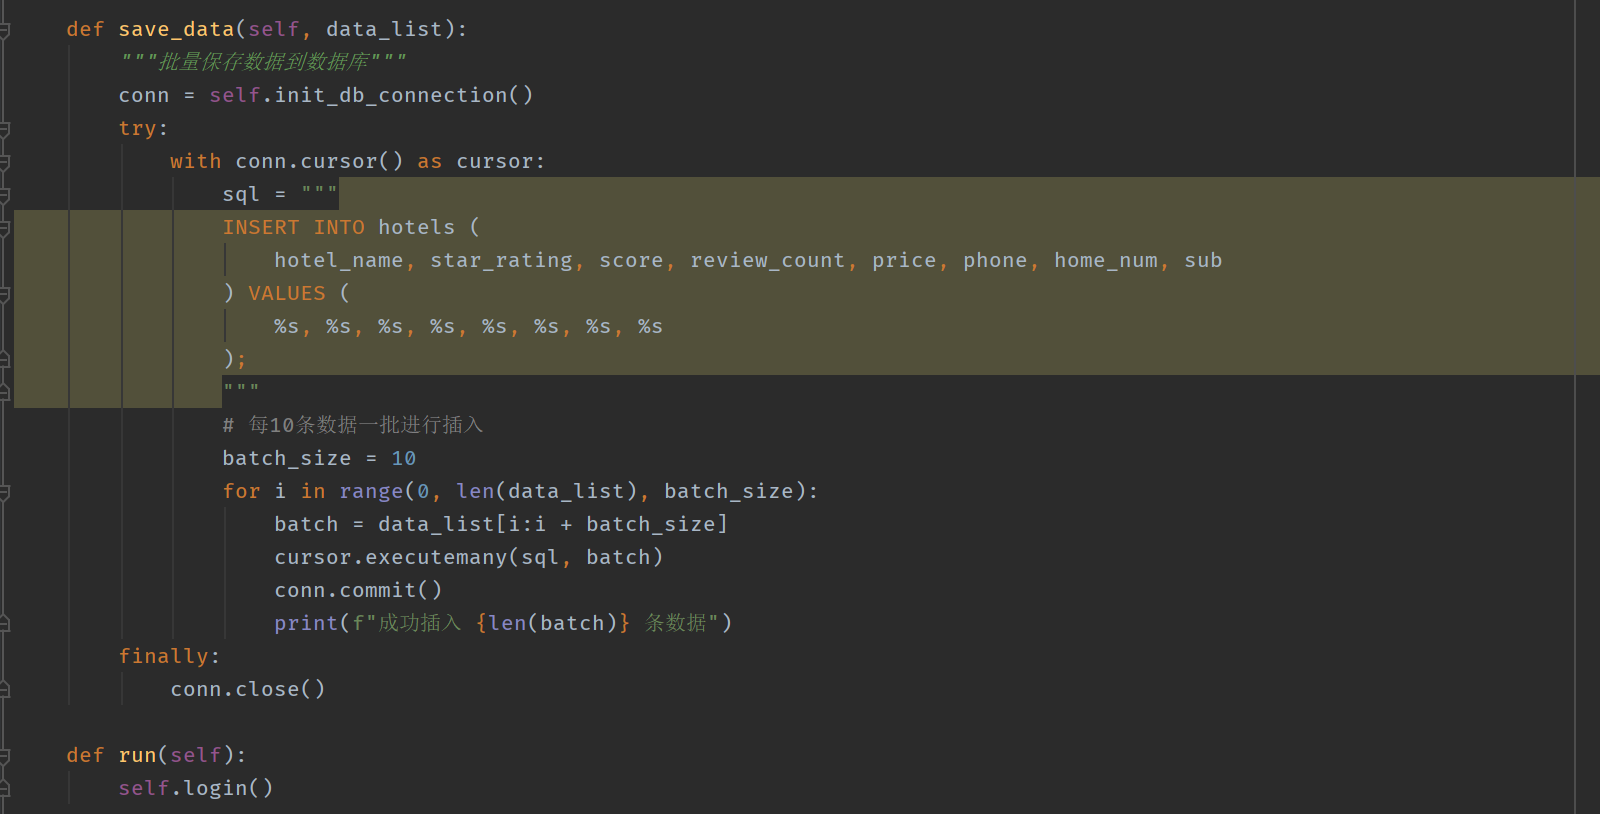
- 将采集的数据保存到MySQL数据库
5. 数据分析模块 (hotel_data_analysis.py)
-
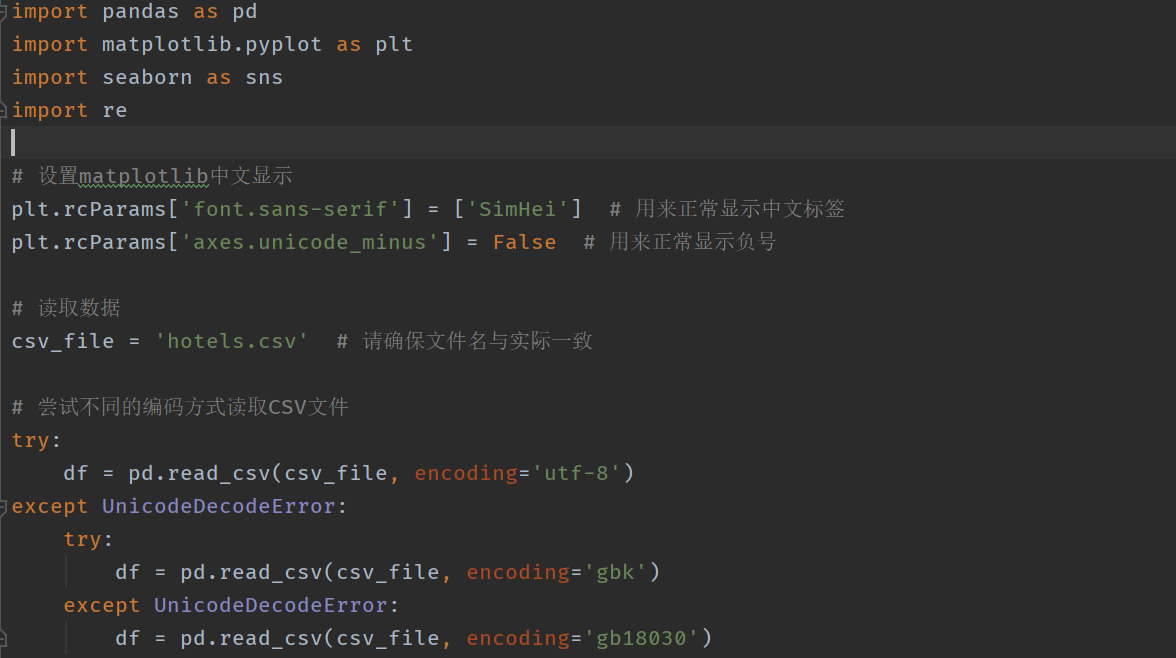
读取CSV数据
-
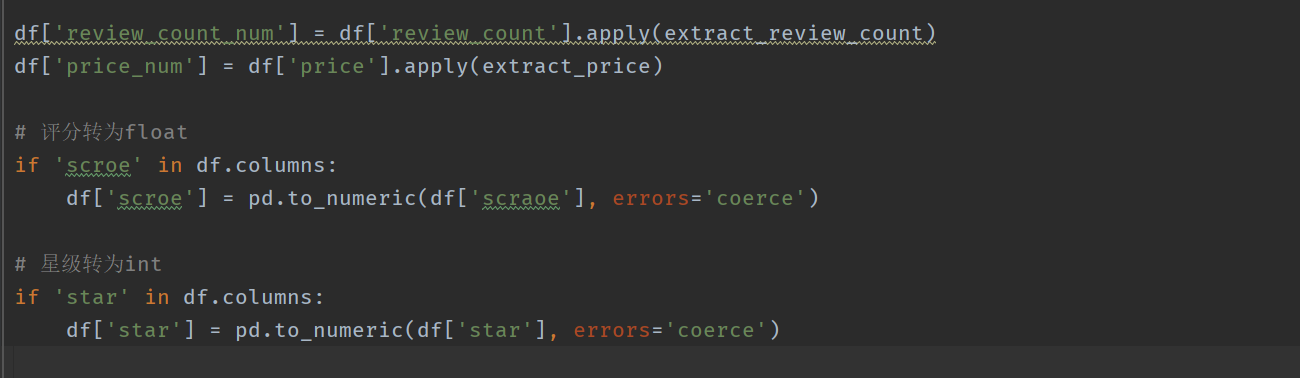
数据清洗和转换
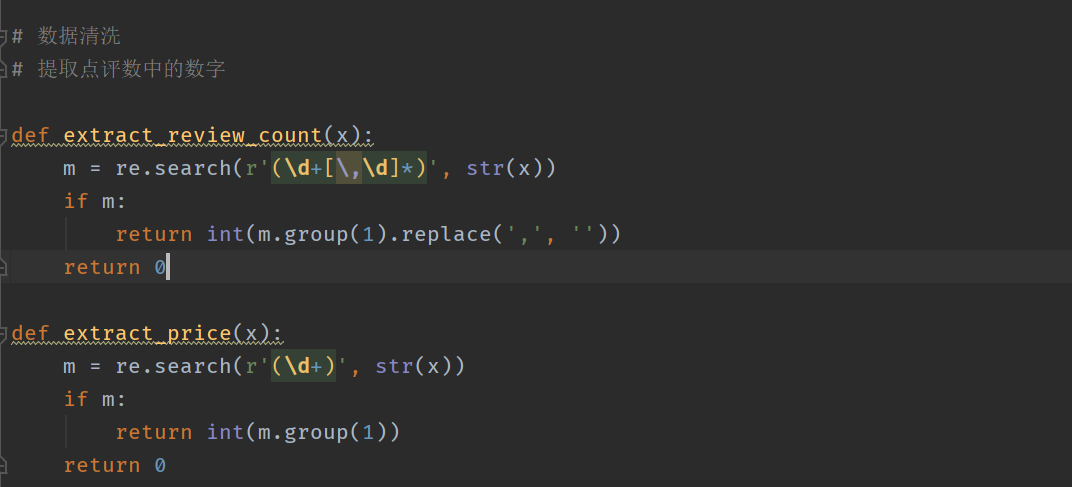
3.提取数值型数据
-
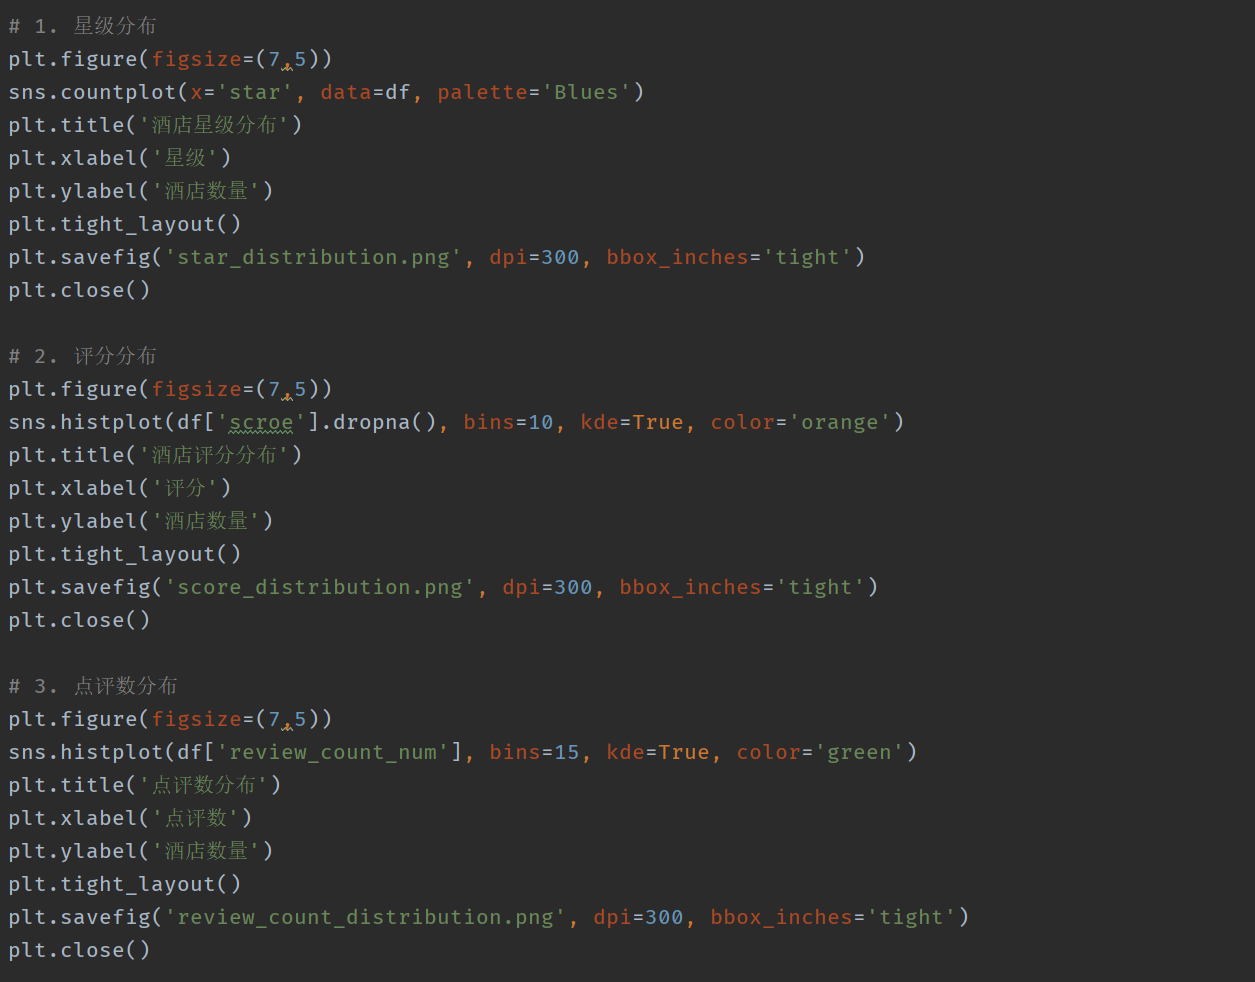
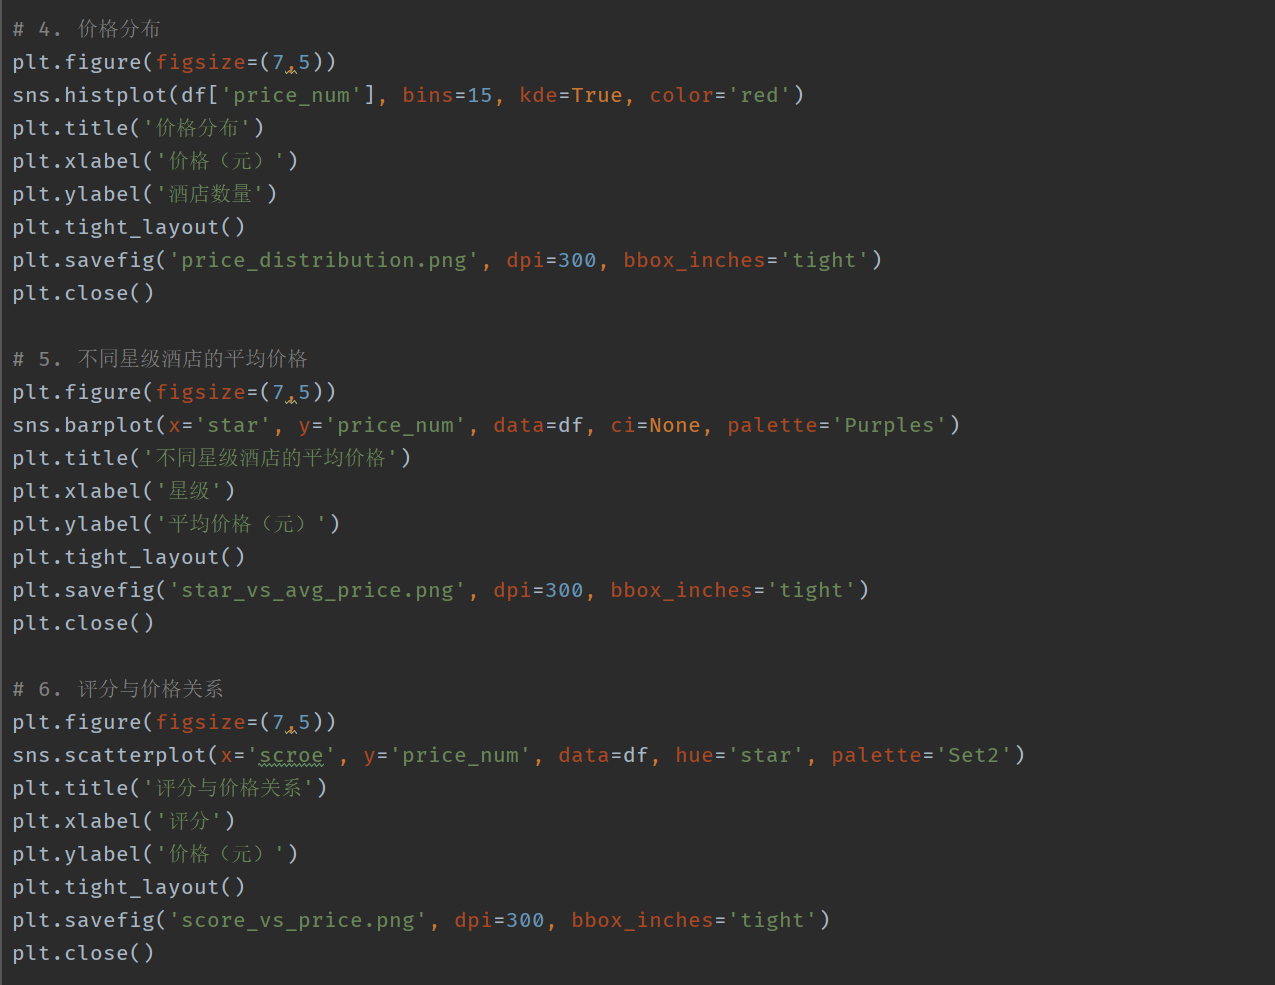
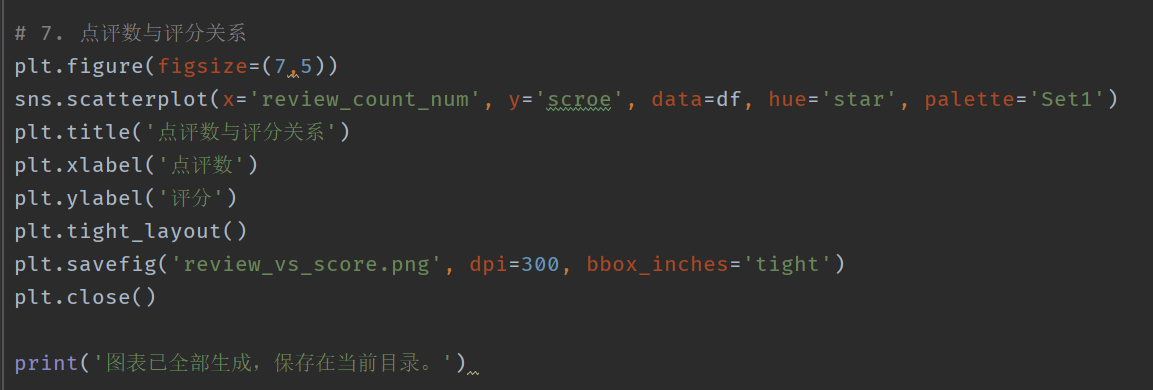
可视化分析
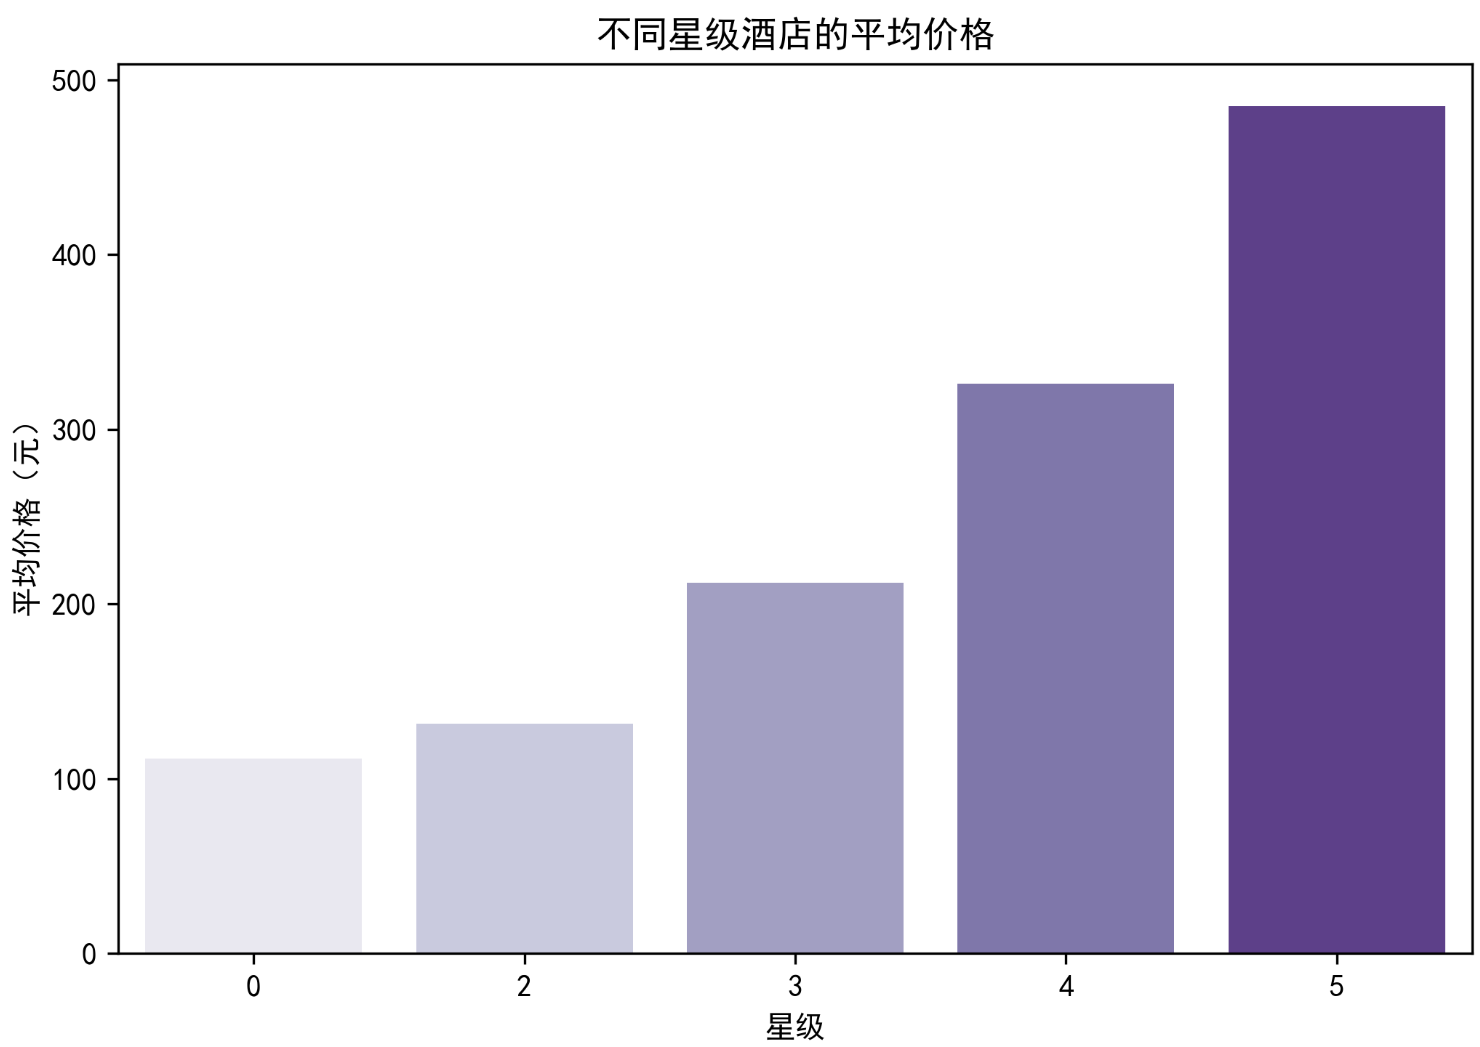
生成多个分析图表:
- 酒店星级分布图
- 评分分布图
- 点评数分布图
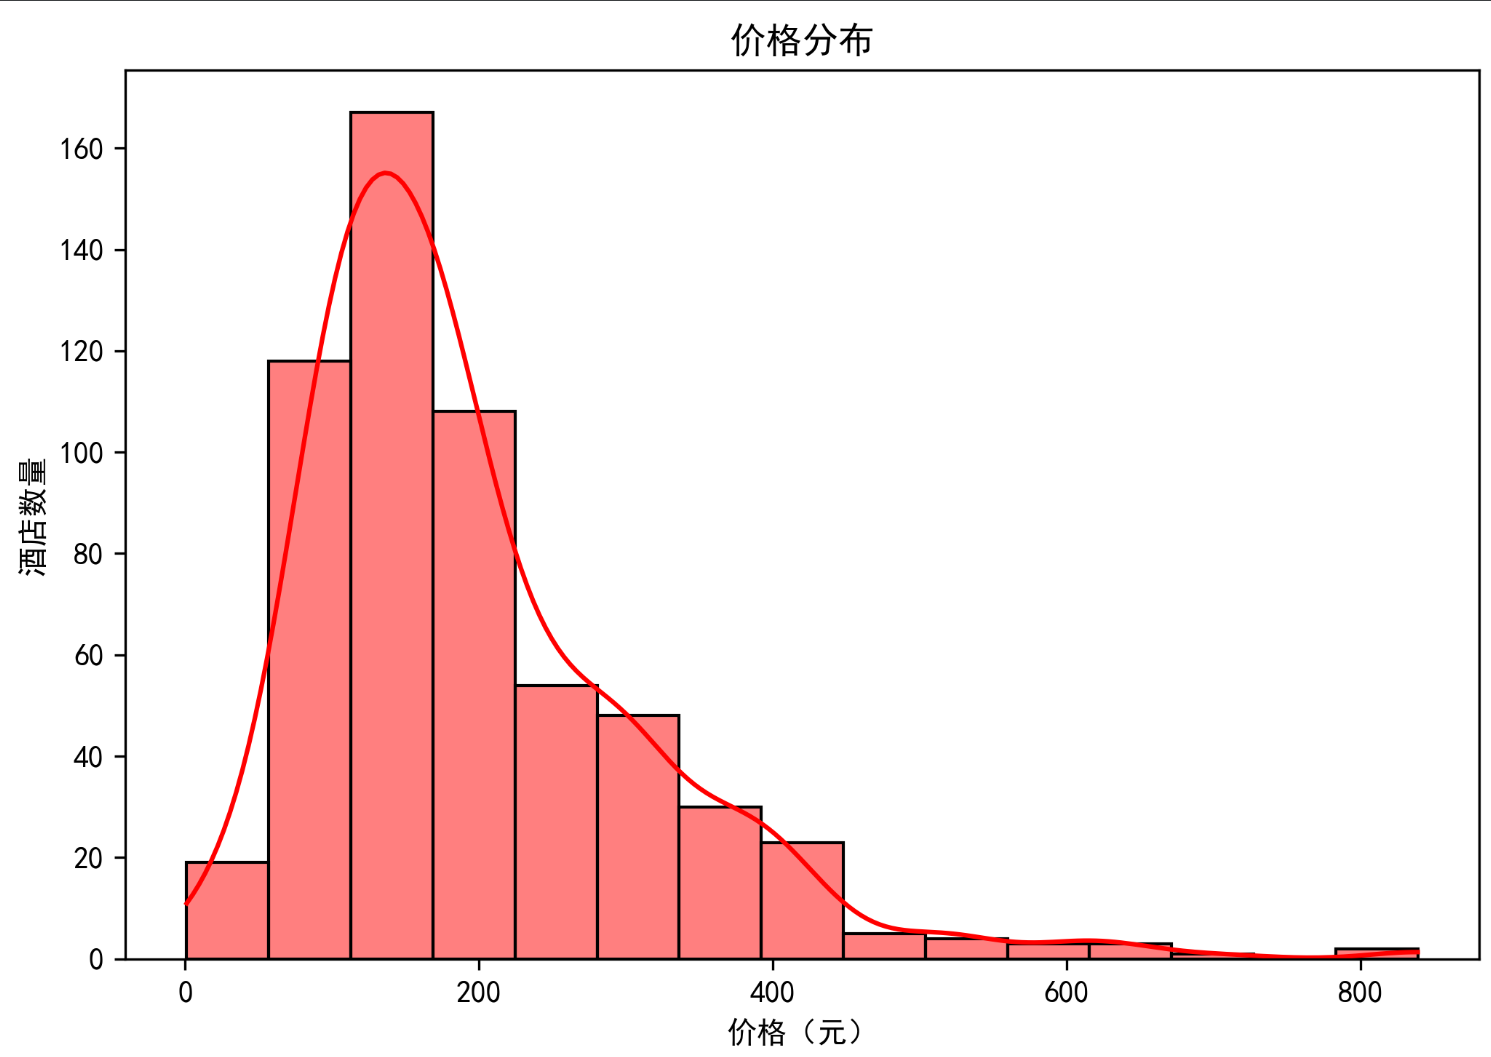
- 价格分布图
- 星级与平均价格关系图
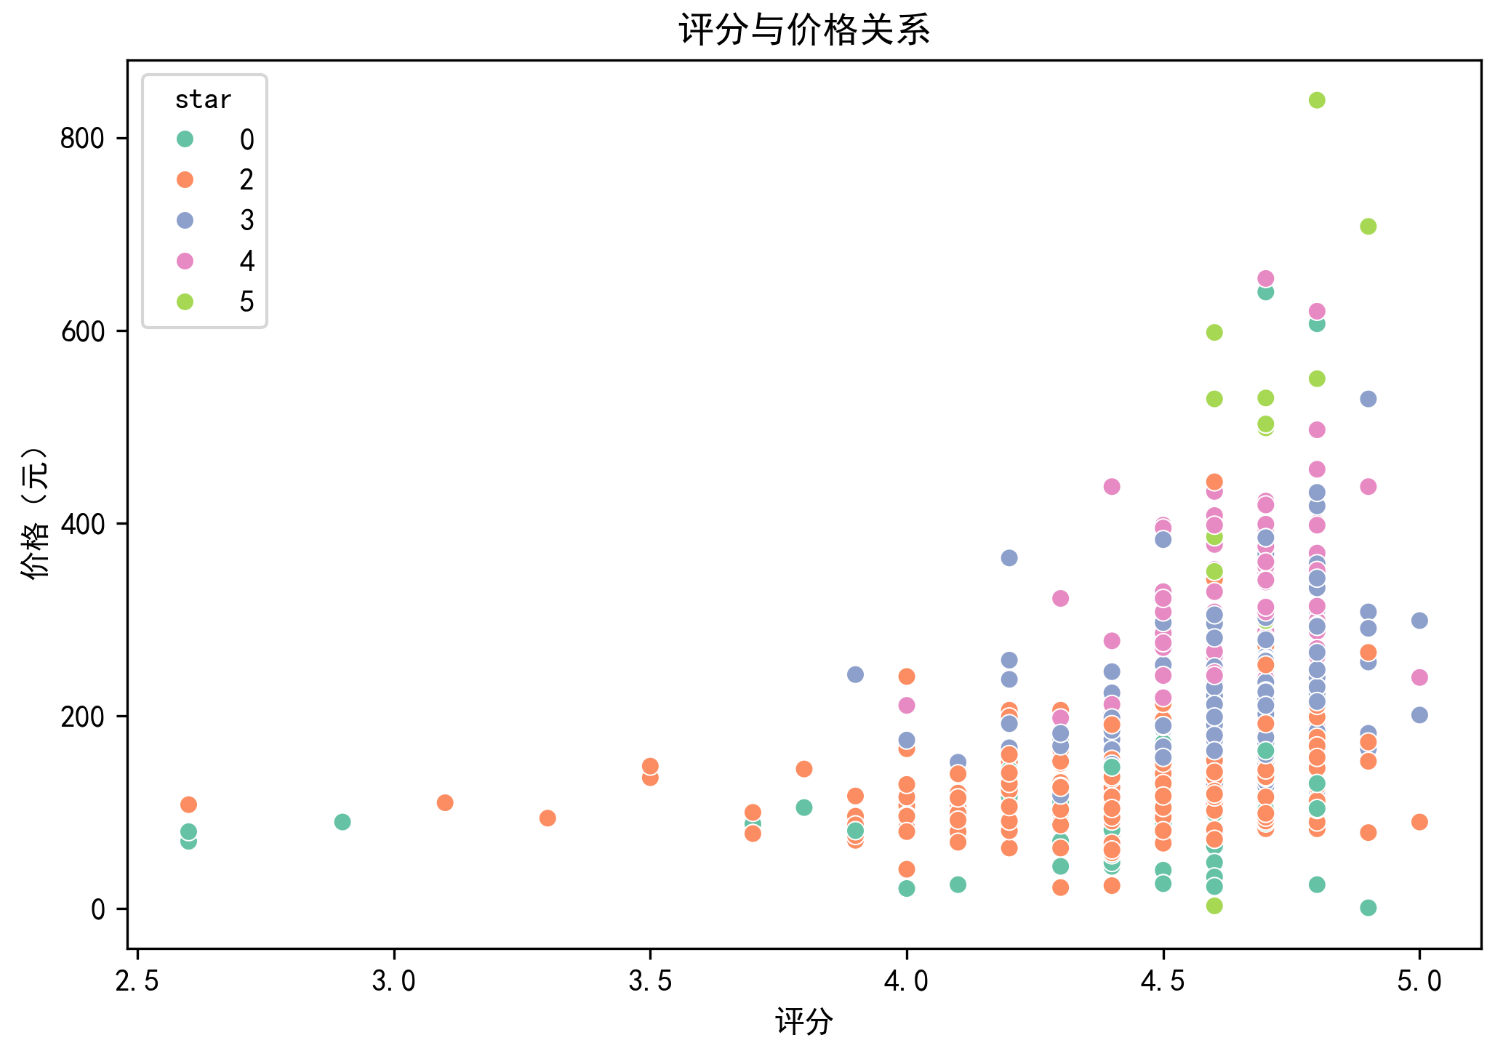
- 评分与价格关系散点图
- 点评数与评分关系散点图
6.总结
-
项目特点
-
自动化程度高:从登录到数据采集全流程自动化
-
反爬虫处理:包含验证码识别、随机延时等机制
-
数据完整性:通过多次滚动确保数据采集完整
-
可视化分析:多维度展示数据特征和关系
-
注意事项
-
需要配置正确的数据库连接信息
-
需要处理网络异常和验证码失败的情况
-
数据采集时需要注意控制频率,避免被封禁
-
分析时注意处理异常值和缺失值
-
输出文件
-
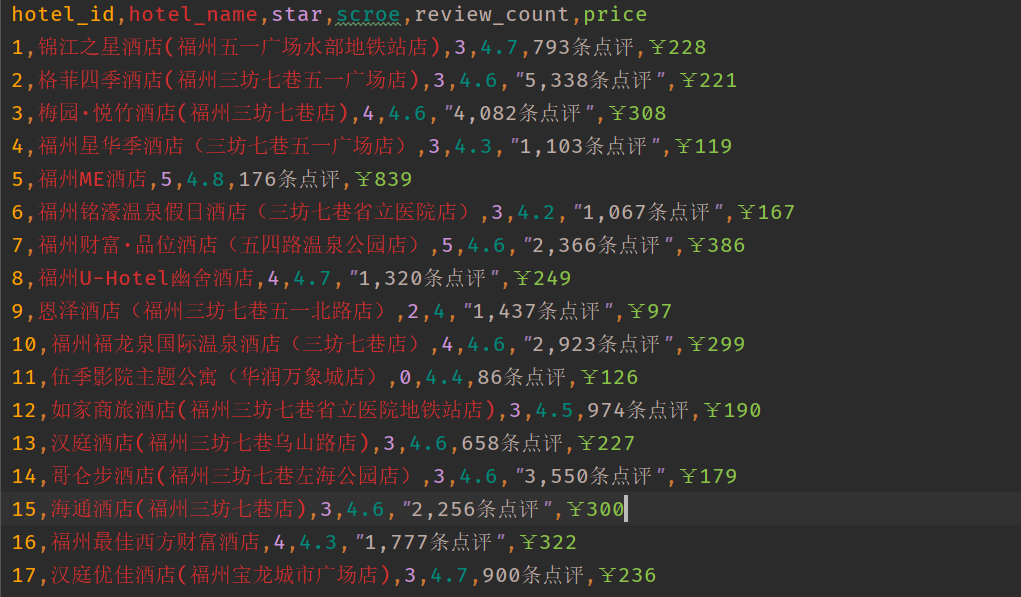
hotels.csv:原始数据文件
-
-
多个.png文件:数据可视化图表
-
-
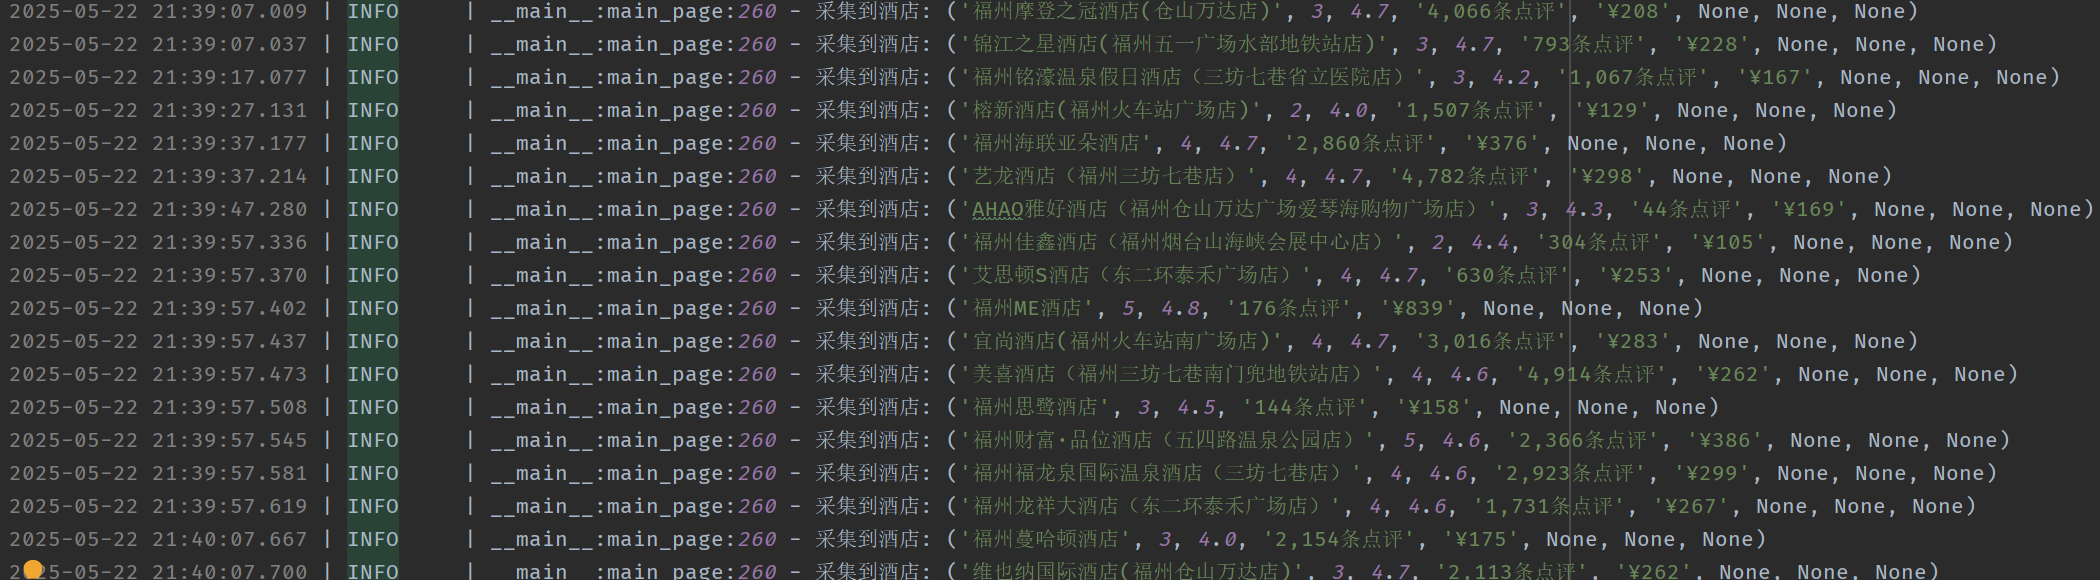
hotels.log:运行日志文件
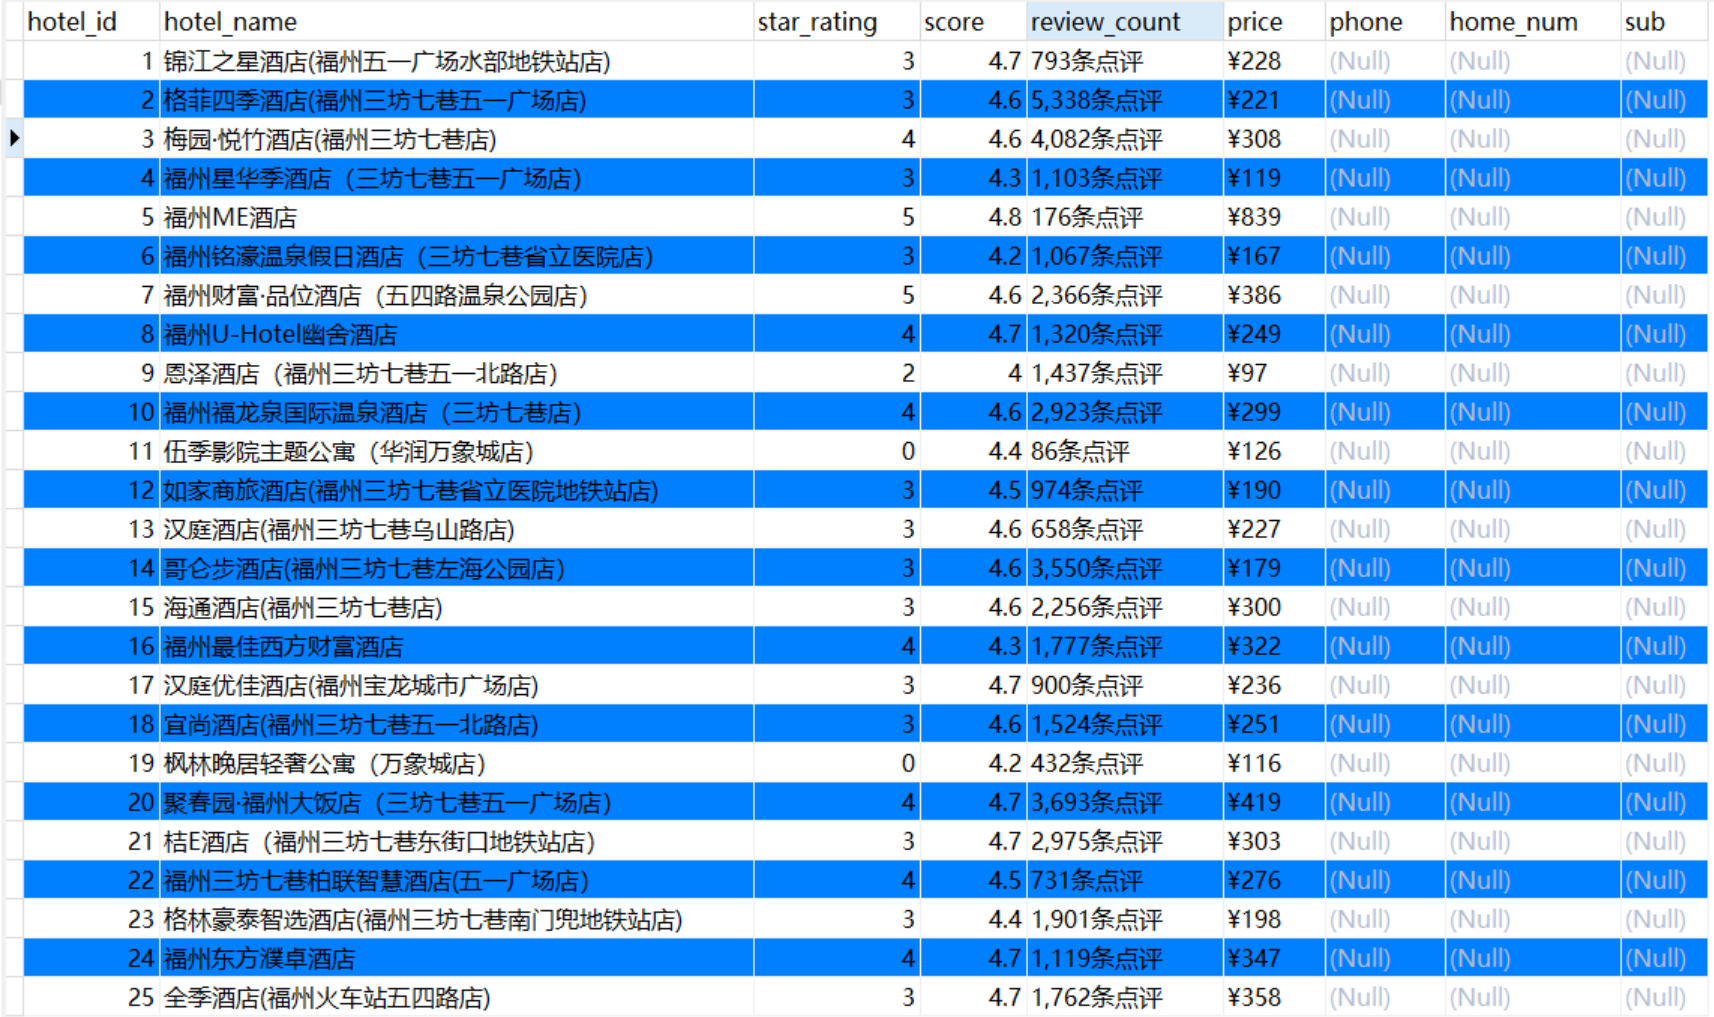
可能涉及隐私的酒店号码和历史本文都未提及,有兴趣可以进入酒店详情页(模态框中存放着相关数据) -
代码用途 本代码仅供学习和技术研究使用:
旨在演示Drissionpage的基本原理和实现方法。使用者需遵守相关法律法规和网站使用条款,不得用于任何非法或商业用途。 数据获取限制 代码仅用于获取公开可见的
更多推荐

 29
 0
- 0


 已为社区贡献1条内容

所有评论(0)